
AI giỏi nhất chỉ đạt 12 bài thi GDPx, 250 năm loài người tìm cách chấm điểm trí tuệ máy
Ngày 2/11/2026, công ty phân tích bán dẫn SemiAnalysis công bố GDPx, một bộ bài kiểm tra mới dành cho các AI agent, tức những mô hình AI có thể tự lên kế hoạch, dùng công cụ và làm việc nhiều giờ liền. Bộ đề gồm 206 nhiệm vụ trong 11 lĩnh vực, từ thiết kế chip, an ninh mạng, sinh học, tài chính, pháp lý đến giao dịch định lượng, được soạn cùng 14 công ty chuyên làm dữ liệu huấn luyện. Kết quả đầu tiên khá phũ: mô hình đứng đầu là Claude Opus 5.5 của Anthropic chỉ đạt 12,0%, Gemini 4 Carbon của Google được 10,9%, GPT-6 Astra của OpenAI được 9,6%. Ở hai mảng tài chính và pháp lý, SemiAnalysis viết rằng đề khó đến mức gần như mọi mô hình đều được đúng 0 điểm nếu chấm theo kiểu đạt hoặc trượt. Những con số này nghe lạ, vì cũng chính các mô hình ấy đã đạt điểm gần tuyệt đối ở hàng loạt bài kiểm tra trước đây. Vậy rốt cuộc AI giỏi hay dở? Câu hỏi “làm sao biết một cỗ máy thông minh đến đâu” thật ra đã có tuổi đời hơn 250 năm, và lịch sử của nó là chuỗi những lần con người tưởng đã tìm ra thước đo chuẩn, rồi lại phải làm thước mới.
Hình ảnh minh họa cho AI giỏi nhất chỉ đạt 12 bài thi GDPx, 250 năm loài người tìm cách chấm điểm trí tuệ máy. Ảnh: Tư liệu
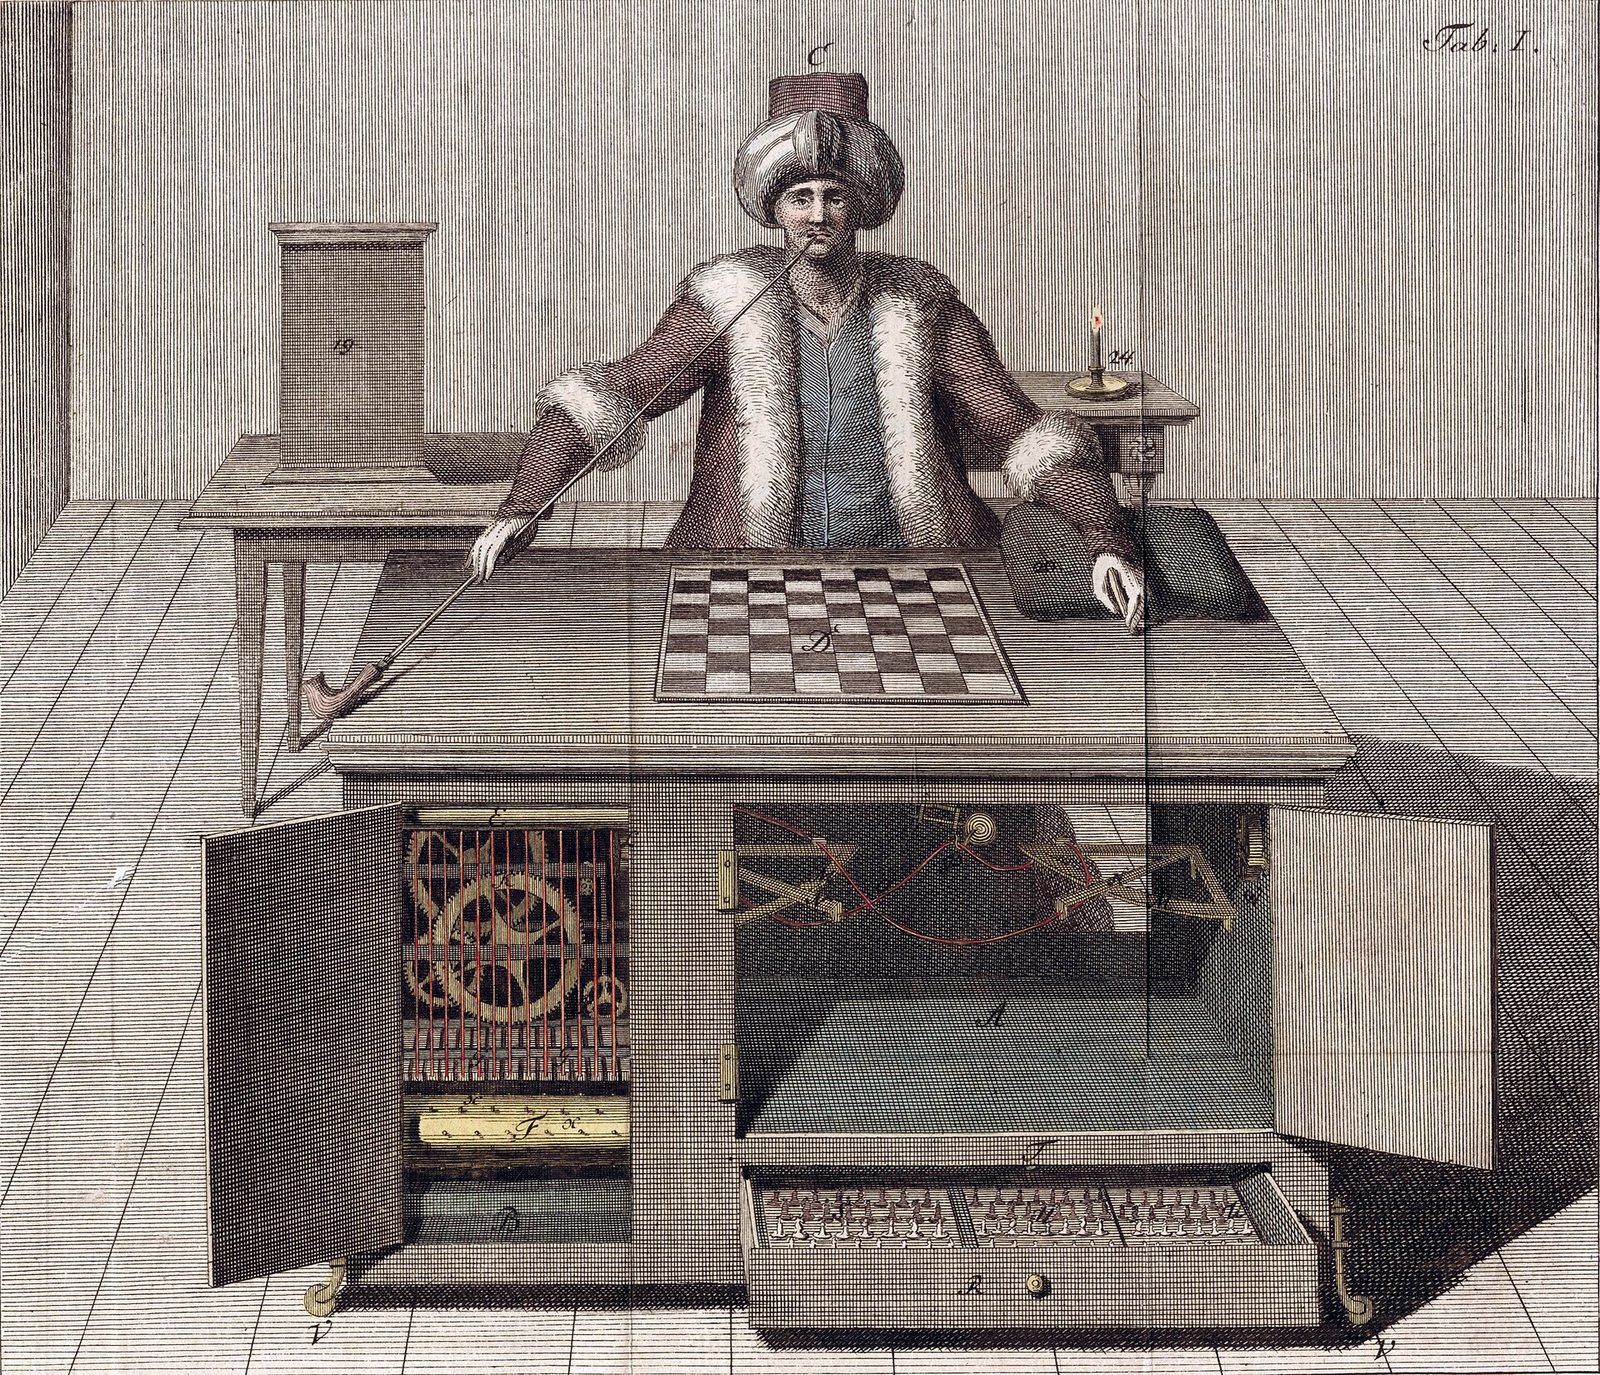
Cỗ máy đánh cờ “người Thổ” của Wolfgang von Kempelen, tranh khắc trong sách của Joseph Racknitz năm 1789, cuốn sách tìm cách giải thích mánh khóe bên trong cỗ máy
Cỗ máy đánh cờ có người ngồi bên trong
Năm 1770, nhà phát minh Wolfgang von Kempelen mang đến cung điện Schönbrunn ở Vienna một cỗ máy để gây ấn tượng với Nữ hoàng Maria Theresa: hình nộm một người đàn ông mặc áo choàng kiểu Ottoman, đội khăn xếp, ngồi sau một chiếc tủ gỗ có bàn cờ ở trên. Người ta gọi nó là “người Thổ” (The Turk). Cỗ máy tự đánh cờ, và đánh rất hay.
Alan Turing đổi câu hỏi
Hình ảnh minh họa cho AI giỏi nhất chỉ đạt 12 bài thi GDPx, 250 năm loài người tìm cách chấm điểm trí tuệ máy. Ảnh: Tư liệu
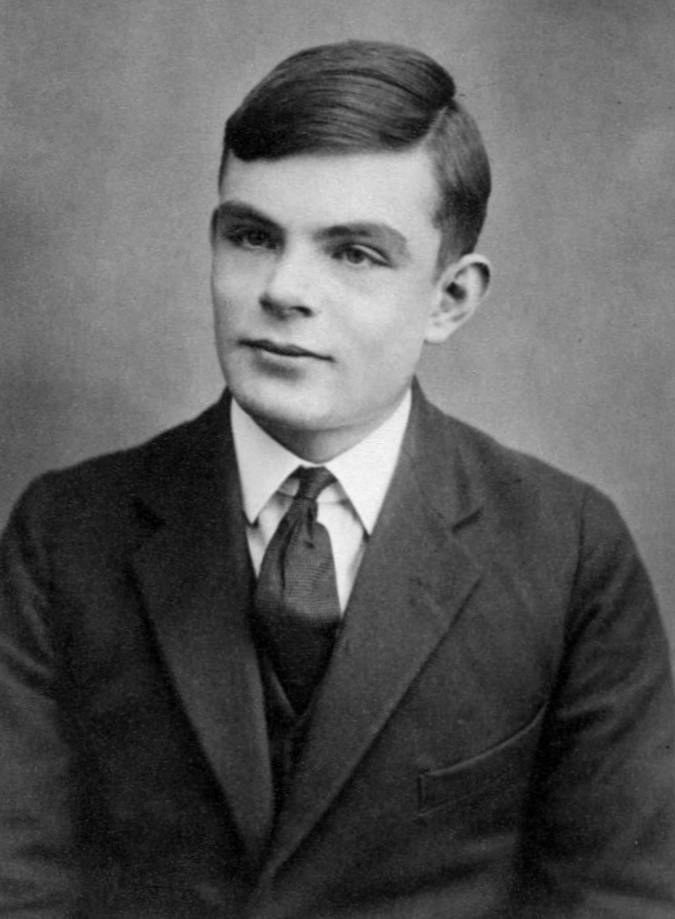
Alan Turing năm 16 tuổi. Năm 1950, ông đề xuất “trò chơi bắt chước”, về sau được gọi là phép thử Turing Năm 1950, nhà toán học người Anh Alan Turing, khi đó làm việc tại Đại học Manchester, đăng bài “Computing Machinery and Intelligence”. Bài mở đầu bằng câu: “Tôi đề nghị xem xét câu hỏi: máy móc có thể suy nghĩ không?”. Nhưng vì “suy nghĩ” rất khó định nghĩa, Turing thay nó bằng một câu hỏi đo được: liệu có máy tính nào chơi tốt “trò chơi bắt chước” hay không, tức là trò chuyện bằng chữ với một người hỏi mà người đó không phân biệt được đâu là máy, đâu là người. Turing còn đưa ra một dự đoán cụ thể: khoảng 50 năm sau, máy tính sẽ chơi trò này giỏi đến mức một người hỏi bình thường, sau 5 phút, không có quá 70% khả năng đoán đúng. Phép thử này không chấm việc máy trả lời đúng hay sai, chỉ chấm việc máy giống người đến đâu.
Bàn cờ trở thành thước đo
Hình ảnh minh họa cho AI giỏi nhất chỉ đạt 12 bài thi GDPx, 250 năm loài người tìm cách chấm điểm trí tuệ máy. Ảnh: Tư liệu
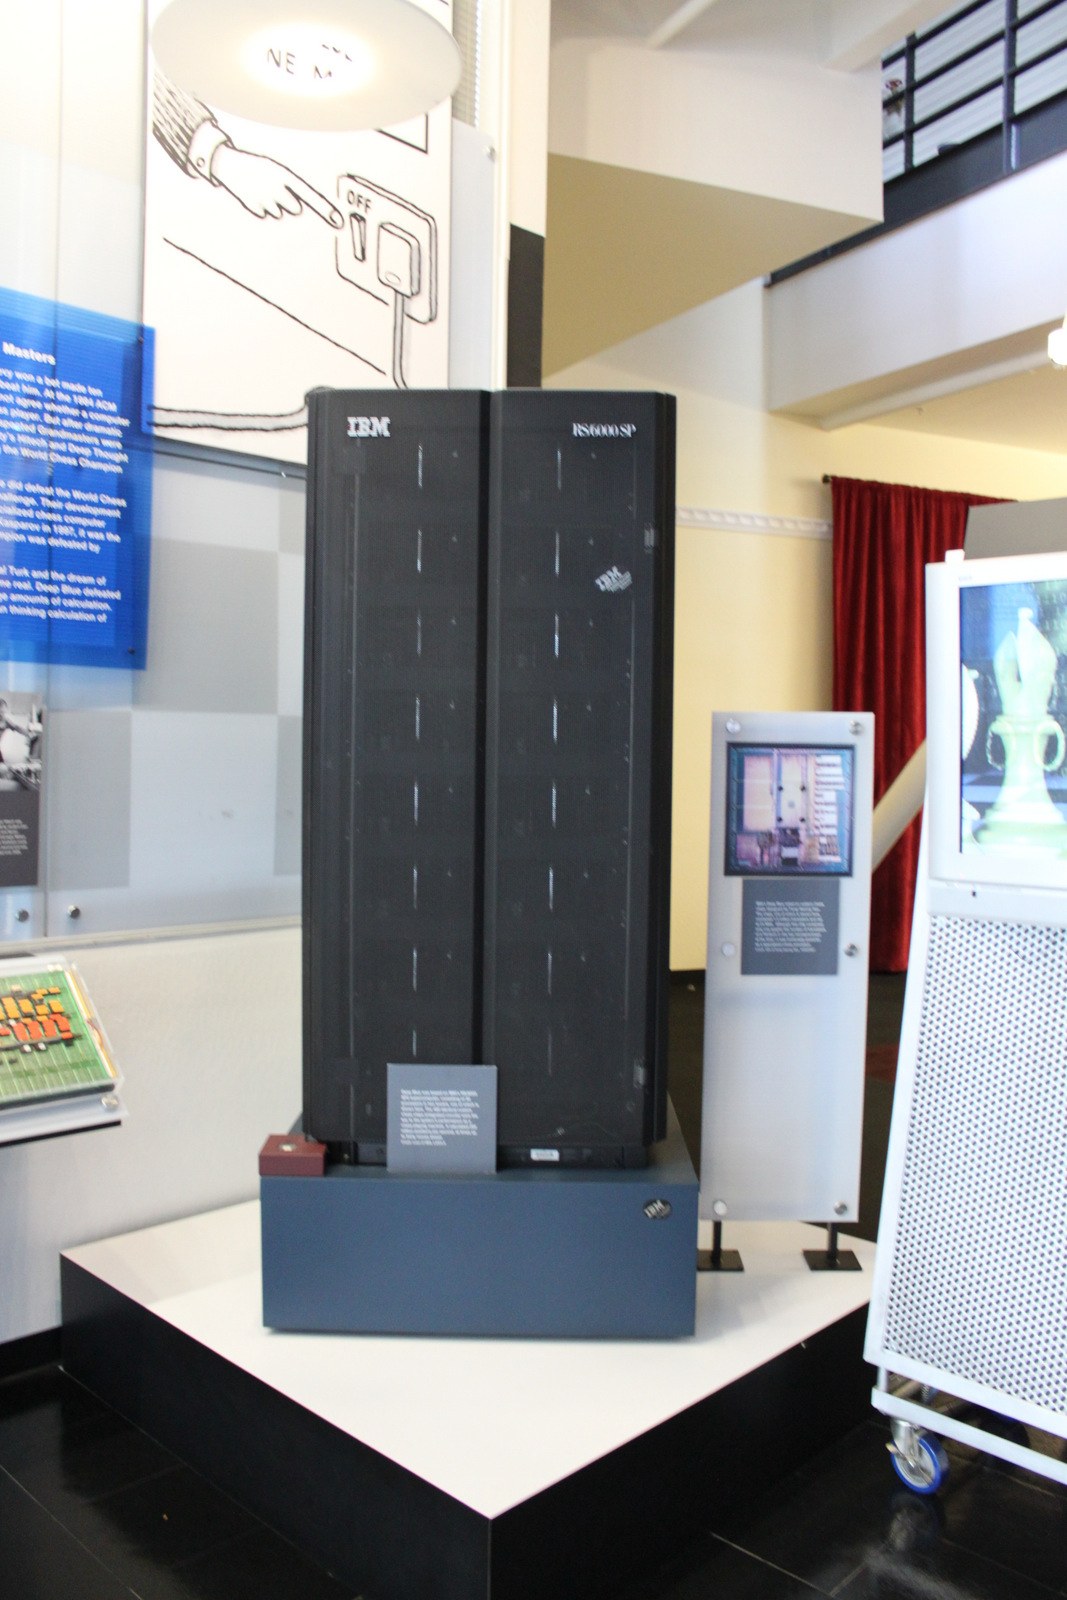
Tủ máy Deep Blue (IBM RS/6000 SP) trưng bày tại Bảo tàng Lịch sử Máy tính ở Mountain View, Mỹ Nhưng Deep Blue không biết làm gì ngoài đánh cờ. Cờ vây trở thành thước đo mới, cho tới khi AlphaGo của Google DeepMind đánh bại Lee Sedol năm 2016. Mỗi khi máy vượt qua một bài kiểm tra, người ta lại nhận ra bài kiểm tra ấy đo được ít hơn mình tưởng.
ImageNet và kỷ nguyên bảng xếp hạng
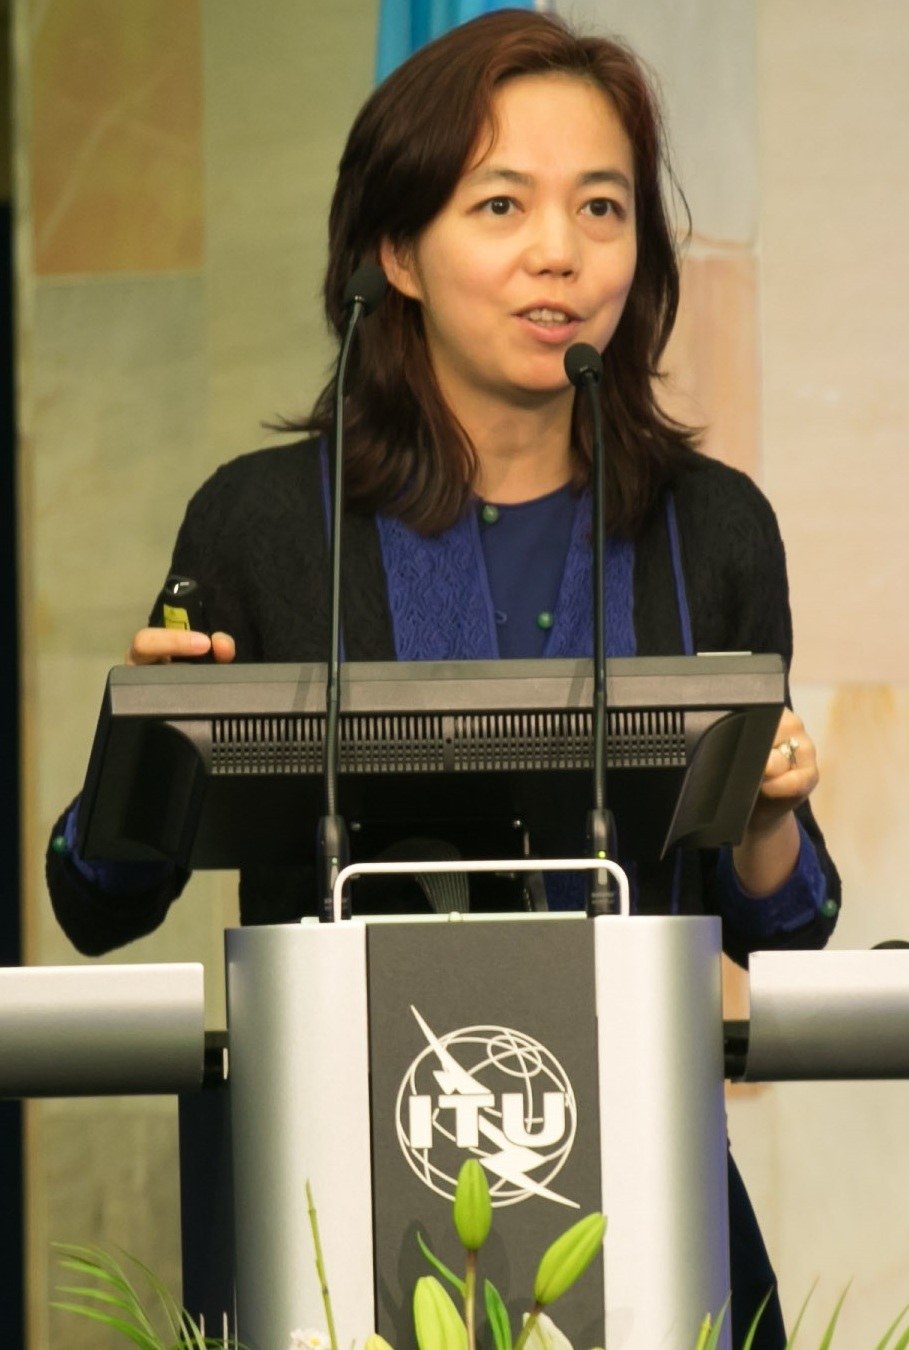
Bước ngoặt tiếp theo không đến từ một trận đấu mà từ một bộ dữ liệu. Năm 2006, nhà nghiên cứu Fei-Fei Li bắt đầu xây dựng ImageNet với một ý tưởng đi ngược số đông: thay vì chỉ cải tiến thuật toán, hãy cho AI thật nhiều dữ liệu tốt. Theo Wikipedia, từ tháng 7/2008 đến tháng 4/2010, nhóm của bà thuê khoảng 49.000 người ở 167 quốc gia lọc và gắn nhãn hơn 160 triệu ảnh ứng viên, để có hơn 14 triệu ảnh được chú thích.
Hình ảnh minh họa cho AI giỏi nhất chỉ đạt 12 bài thi GDPx, 250 năm loài người tìm cách chấm điểm trí tuệ máy. Ảnh: Tư liệu
Fei-Fei Li phát biểu tại hội nghị AI for Good năm 2017 ở Geneva. Bộ dữ liệu ImageNet do bà khởi xướng đã mở ra kỷ nguyên học sâu
Khi thước đo biến thành mục tiêu
Với mô hình ngôn ngữ, đề thi nổi tiếng nhất là MMLU, do Dan Hendrycks và cộng sự công bố ngày 7/9/2020: gần 16.000 câu trắc nghiệm thuộc 57 môn, từ toán, luật quốc tế đến dinh dưỡng. Khi ra mắt, phần lớn mô hình chỉ đạt quanh mức đoán mò 25%, GPT-3 đạt 43,9%. Đến giữa năm 2024, các mô hình mạnh như Claude 3.5 Sonnet, GPT-4o hay Llama 3.1 405B đều đạt khoảng 88%, sát mức chuyên gia mà nhóm tác giả ước tính là 89,8%. Đề thi “bão hòa” chỉ sau chưa đầy bốn năm. Tệ hơn, một nghiên cứu tháng 6/2024 rà lại 5.700 câu hỏi và ước tính khoảng 6,5% câu của MMLU có lỗi, như có nhiều đáp án đúng hoặc đáp án sai hẳn. Đề thi lại công khai trên mạng nên rất dễ lọt vào dữ liệu huấn luyện, giống học sinh học tủ đúng bộ đề sắp thi. Tháng 1/2025, Trung tâm An toàn AI và Scale AI tung ra “Humanity’s Last Exam” (Kỳ thi cuối cùng của nhân loại) với 2.500 câu hỏi cực khó do chuyên gia khắp thế giới đóng góp. Chỉ vài tháng sau, FutureHouse cho rằng khoảng 30% đáp án phần hóa và sinh của nó có thể sai. Giới kinh tế có một câu đúc kết cho hiện tượng này, gọi là định luật Goodhart, theo tên nhà kinh tế người Anh Charles Goodhart với bài viết năm 1975: “Khi một thước đo trở thành mục tiêu, nó không còn là thước đo tốt nữa”. Khi cả ngành đua nhau tối ưu cho một bảng điểm, điểm số tăng nhanh hơn năng lực thật.
Từ đề thi đến công việc thật
Ngày 25/9/2025, OpenAI chuyển hướng với GDPval: thay vì câu hỏi kiểu đề thi, họ lấy sản phẩm công việc thật như bản tóm tắt pháp lý, bản vẽ kỹ thuật hay kế hoạch chăm sóc bệnh nhân. Bộ đầy đủ có 1.320 nhiệm vụ thuộc 44 nghề trong 9 ngành đóng góp nhiều nhất vào GDP Mỹ, do các chuyên gia trung bình 14 năm kinh nghiệm soạn. Chữ “GDP” trong tên gọi cũng từ đó mà ra. SemiAnalysis cho rằng GDPval, dù vẫn phổ biến nhất trong các tài liệu ra mắt mô hình, đã lỗi thời. Theo bài viết của nhóm tác giả Max Kan, Andrew Megalaa và Dylan Patel, mọi nhiệm vụ GDPval đều được mô tả sẵn, làm trong một lượt, toàn bộ thông tin cần thiết được “đút tận miệng” trong đề bài. Chính OpenAI khi công bố cũng thừa nhận GDPval chỉ đánh giá một lượt. Trong khi đó, phần khó nhất của công việc thật lại chính là đi tìm thông tin: lục email, file Excel, hợp đồng, báo cáo. GDPx được thiết kế để lấp khoảng trống đó. Mỗi nhiệm vụ có một “môi trường” mô phỏng nơi làm việc. Ví dụ, phần tài chính đặt AI vào một thương vụ quỹ đầu tư mua khoảng 62% cổ phần một công ty đồ ăn vặt với giá 880 triệu USD, được dựng lại từ một giao dịch có thật, với khoảng 4.000 file đã ẩn danh. Phần an ninh mạng thì dựa trên các lỗ hổng zero-day có thật. Mỗi nhiệm vụ có hạn mặc định 8 giờ, mô hình chạy trong công cụ riêng như Claude Code hay Codex, điểm là trung bình ba lần thử. SemiAnalysis cũng rút kinh nghiệm từ chuyện đề thi bị lỗi: mọi đối tác phải vượt qua quy trình kiểm định chất lượng tự động ngay lần đầu. Họ cho biết khi chạy cùng quy trình đó trên bộ Terminal Bench 4.0, gần 50% nhiệm vụ bị gắn cờ là hỏng.
Con số 12% nói lên điều gì
Điều đáng chú ý nhất không phải ai đứng đầu, mà là AI trượt ở đâu. Theo Datacurve, đối tác soạn phần kỹ thuật phần mềm, 76% số lần mô hình thất bại liên quan đến những yêu cầu xung quanh nhiệm vụ chính, như giữ nguyên hành vi cũ của phần mềm hay xử lý các trường hợp ngoại lệ. Mô hình cũng hay tự viết bài kiểm tra để xác nhận mình đúng, thay vì thử thách lời giải. Ở bài kiểm toán chất lượng lợi nhuận của phần tài chính, không mô hình nào hoàn thành trong 25 lần thử: chúng tính toán đúng nhưng hay bỏ qua những hệ quả mà một người duyệt có kinh nghiệm sẽ thấy ngay. Điểm số cũng rất “lởm chởm”. Opus 5.5 mạnh nhất ở giao dịch định lượng, thiết kế phần cứng và thiết kế chip; Gemini 4 Carbon dẫn ở sinh học và nhỉnh hơn ở kỹ thuật phần mềm; GPT-6 Astra thắng rõ ở mảng “tự cải tiến” và khoa học vật liệu. Chi phí mỗi nhiệm vụ chênh nhau rất xa, từ 0,92 USD với GPT-6 Luna đến 67,16 USD với Claude Fable 5.1. SemiAnalysis còn lưu ý rằng điểm của Opus 5.5 và GPT-6 Astra bị kéo xuống vì bộ lọc an toàn đôi khi chặn việc ở ba mảng an ninh mạng, sinh học và alignment. Cũng cần nhìn GDPx bằng con mắt tỉnh táo. Đây là số liệu do chính SemiAnalysis đo, các đối tác soạn đề đều là công ty bán dữ liệu cho các phòng thí nghiệm AI, và đã có người đặt câu hỏi về cách chấm một số bài tài chính và bộ mô phỏng giao dịch. SemiAnalysis nói sẽ ra phiên bản mới mỗi 3 đến 6 tháng, tức chính họ cũng biết rằng bộ đề này rồi sẽ bão hòa như những bộ đề trước. Từ “người Thổ” của Kempelen đến GDPx, mỗi thế hệ thước đo đều sinh ra để vá lỗ hổng của thế hệ trước: từ “trông có vẻ thông minh” sang “trả lời đúng”, rồi sang “làm được việc thật”. Và bài học năm 1770 vẫn đúng: muốn biết một cỗ máy giỏi đến đâu, phải mở tủ ra xem bên trong nó thực sự làm gì. Với các AI agent sắp được giao những việc kéo dài hàng giờ, con số 12% là lời nhắc rằng chúng ta vẫn nên tự viết tiêu chí nghiệm thu, thay vì để AI tự chấm bài của mình. Anh em đang dùng AI agent cho việc gì, và có tin nổi con số 12% này không? Nguồn: SemiAnalysis, GDPx Leaderboard, Subagentic, AI Primer, OpenAI (GDPval), Wikipedia (The Turk), Wikipedia (Turing test), Wikipedia (Deep Blue), Wikipedia (ImageNet), Wikipedia (Amazon Mechanical Turk), Wikipedia (MMLU), Wikipedia (Humanity’s Last Exam), Wikipedia (Goodhart’s law)
Nguồn thông tin: Tổng hợp và biên tập từ chuyên trang công nghệ.