
AI Memorization, khi mô hình không chỉ học mà còn tái tạo nguyên văn nội dung gốc
Trong nhiều năm qua, các công ty AI luôn kể cho anh em một câu chuyện rất dễ nghe: các mô hình AI hiện đại “học” giống con người, chúng không ghi nhớ từng cuốn sách hay bài viết cụ thể, mà chỉ rút ra “mẫu hình ngôn ngữ” trừu tượng. Nhưng những nghiên cứu mới đây, trong đó có một nghiên cứu của nhóm Stanford và Yale về khả năng trích xuất sách từ các mô hình thương mại, đang làm nứt vỡ câu chuyện đó. Thực tế khó chịu hơn nhiều: các mô hình AI không chỉ học, chúng lưu trữ, và trong những điều kiện nhất định, chúng có thể phun ngược lại những đoạn văn rất dài từ dữ liệu huấn luyện ban đầu, từ Harry Potter, 1984, The Great Gatsby cho đến các bài luận nổi tiếng. Và đây không phải là một chi tiết kỹ thuật vô hại, mà là một cơn ác mộng về pháp lý, kinh tế và kiểm soát hình ảnh cho cả ngành công nghiệp AI, nhất là khi nhiều công ty từng cam đoan với cơ quan quản lý rằng “mô hình không chứa bản sao dữ liệu huấn luyện”.
“Memorization” ở đây thực sự là gì?
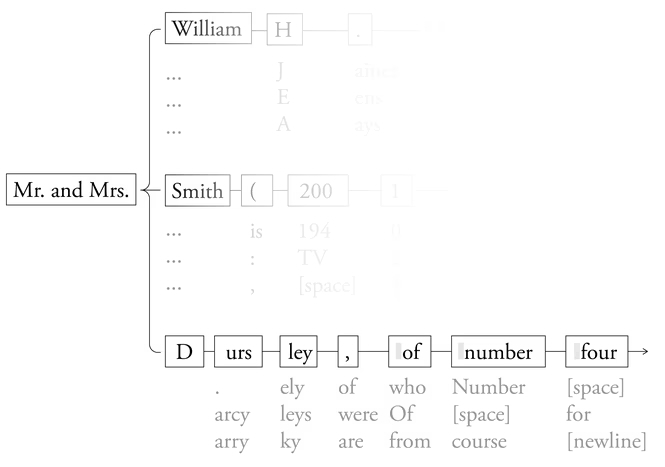
Khi các nhà nghiên cứu nói về “memorization”, sự ghi nhớ, họ không có ý nói rằng AI nhớ theo kiểu con người nhớ một kỷ niệm hay một câu chuyện. Ở đây, “ghi nhớ” có nghĩa rất cụ thể: trong mô hình tồn tại những cấu trúc đủ chi tiết để khi được gợi đúng cách, nó có thể tái tạo lại những đoạn văn gần như nguyên vẹn từ các cuốn sách, bài báo hay tác phẩm nghệ thuật mà nó từng được huấn luyện.
Hình ảnh minh họa cho AI Memorization, khi mô hình không chỉ học mà còn tái tạo nguyên văn nội dung gốc. Ảnh: Tư liệu
Ví dụ về việc ghi nhớ với mô hình Ollama
Nén mất dữ liệu và sự khác biệt với cách con người học
Để hiểu rõ hơn chuyện này, cần bỏ qua ẩn dụ “AI học như con người”, vốn rất hấp dẫn về mặt truyền thông, và nhìn vào cách các kỹ sư mô tả chính công nghệ của họ: lossy compression, tức nén mất dữ liệu.
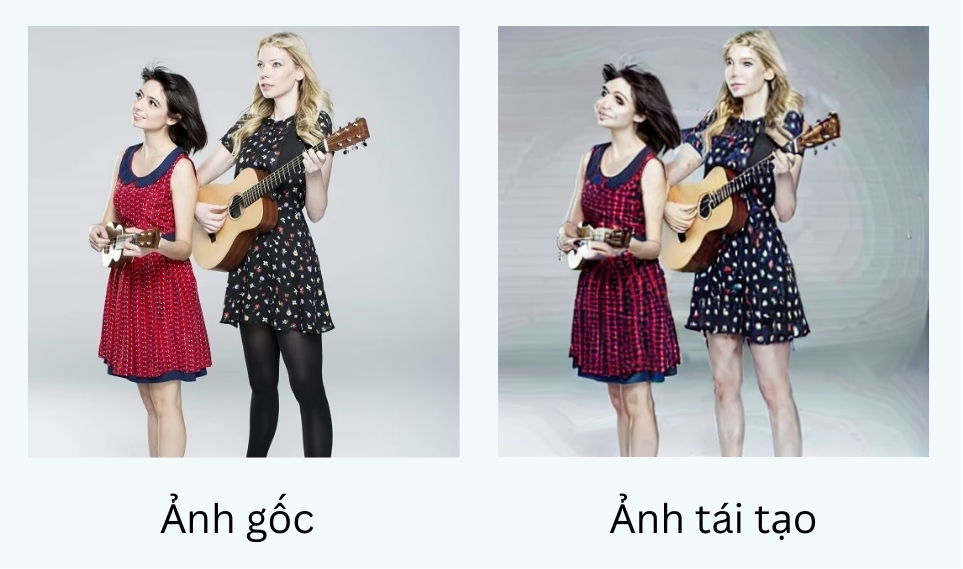
Hình ảnh minh họa cho AI Memorization, khi mô hình không chỉ học mà còn tái tạo nguyên văn nội dung gốc. Ảnh: Tư liệu
Ảnh gốc, khi nén lossy được tái tạo có thể cho ra sản phẩm được coi là đủ thông tin so với ảnh gốc Hãy nghĩ đến file JPEG hay MP3. Khi anh em nén một bức ảnh hay một bài nhạc, anh em không giữ nguyên toàn bộ dữ liệu gốc, nhưng thuật toán vẫn giữ lại đủ thông tin để tái tạo lại một phiên bản rất giống bản ban đầu. AI hoạt động theo cách tương tự: nó “nuốt” một lượng dữ liệu khổng lồ, sau đó nén lại thành một mô hình nhỏ hơn rất nhiều, nhưng vẫn có khả năng tạo ra các đầu ra trông quen thuộc một cách đáng ngờ. Với mô hình tạo sinh ảnh như Stable Diffusion, điều này thể hiện rất rõ: chỉ với một caption trùng với mô tả gốc, mô hình có thể sinh ra hình ảnh gần như giống hệt poster phim, ảnh promo trên web hoặc tranh minh họa của nghệ sĩ, đôi khi chỉ khác ở vài chi tiết nhỏ và một lớp “nhiễu” mờ kiểu JPEG. Điểm khác biệt quan trọng là: con người học thông qua trải nghiệm, cảm giác, suy luận và ý thức. Khi đọc một cuốn sách, con người không thể “phun” lại từng câu chữ chính xác sau hàng năm trời. AI thì khác. Nó không có trải nghiệm, không có cảm xúc, không có phán đoán thẩm mỹ. Nó chỉ lưu trữ các mối liên hệ thống kê giữa những mảnh ngôn ngữ và ngữ cảnh, và khi điều kiện đủ chính xác, những mối liên hệ đó dẫn thẳng đến văn bản gốc, giống như giải nén một file nén chất lượng thấp chứ không phải “hiểu” nội dung theo nghĩa thông thường.
Cách các mô hình ngôn ngữ giữ lại sách vở
Hình ảnh minh họa cho AI Memorization, khi mô hình không chỉ học mà còn tái tạo nguyên văn nội dung gốc. Ảnh: Tư liệu
Sau hàng tỷ ví dụ như vậy, mô hình trở thành một “bản đồ xác suất” khổng lồ. Khi tạo văn bản, nó đơn giản là đi dọc theo bản đồ này, chọn token có xác suất cao nhất tại mỗi bước. Vấn đề nằm ở chỗ: với những tác phẩm phổ biến, xuất hiện nhiều lần và có cấu trúc ngôn ngữ đặc thù, bản đồ này dày đặc đến mức nó chứa cả con đường hoàn chỉnh của tác phẩm gốc. Ở cấp độ nghiên cứu, người ta có thể nhìn vào các xác suất nội bộ này và thấy rằng đường đi “tối ưu” qua không gian token của mô hình thực chất chính là văn bản của một cuốn sách hay bài luận cụ thể. Chỉ cần đưa vào vài token mở đầu chính xác, mô hình có thể “trượt” theo con đường đó và tái tạo lại gần như toàn bộ văn bản. Việc thêm một chút ngẫu nhiên trong quá trình sinh văn bản – thứ thường được quảng bá là để tăng “sáng tạo” – thực chất cũng giúp che giấu việc sao chép này, chứ không loại bỏ nó; khi giảm hoặc loại bỏ ngẫu nhiên và khéo “mớm” đầu vào, mô hình bộc lộ rõ mức độ ghi nhớ.
Và vì thế, đây là vấn đề pháp lý và kinh tế lớn
Vậy thì, nếu AI có thể tái tạo tác phẩm có bản quyền, câu hỏi pháp lý trở nên rất nhạy cảm. Thứ nhất, người ta có thể lập luận rằng bản thân mô hình đã là một bản sao bất hợp pháp, dù là ở dạng nén, hoặc là một tập “hướng dẫn” có khả năng tạo lại bản sao theo yêu cầu. Nếu tòa án chấp nhận cách hiểu này, hậu quả không chỉ là tiền phạt, mà còn có thể buộc các công ty phải hủy và huấn luyện lại toàn bộ mô hình bằng dữ liệu có bản quyền hợp lệ.
Hình ảnh minh họa cho AI Memorization, khi mô hình không chỉ học mà còn tái tạo nguyên văn nội dung gốc. Ảnh: Tư liệu
Kiểm soát câu chuyện và nghiên cứu bị kìm hãm
Một chi tiết đáng lo ngại khác là: nghiên cứu về memorization dường như không được khuyến khích phát triển. Nhiều nhà nghiên cứu cho biết các công ty AI có xu hướng né tránh, gây áp lực pháp lý hoặc trực tiếp cản trở những công trình đào sâu vào vấn đề này; một số người chỉ dám chia sẻ ẩn danh vì lo sợ bị trả đũa. Trong khi đó, câu chuyện “AI học như con người” vẫn được lặp đi lặp lại, với những so sánh như “dạy trẻ em viết văn” được viện dẫn cả trong tòa án, bởi nó giúp xoa dịu công chúng, thuyết phục tòa án, và giữ cho bánh xe đầu tư tiếp tục quay. Các lãnh đạo như Sam Altman còn nói về “quyền được học” của AI từ sách báo, như một cách gắn mô hình với hình ảnh con người đọc sách, dù thực tế mô hình đang nén và tái tạo lại nội dung chứ không “học” bằng trải nghiệm. Khi một công nghệ trị giá hàng nghìn tỷ đô phụ thuộc vào một ẩn dụ đẹp đẽ nhưng sai lệch, việc bóp nghẹt những câu hỏi khó trở thành điều dễ hiểu, dù không thể chấp nhận về mặt đạo đức khoa học.
Kết luận
Thật ra, cuộc khủng hoảng “memorization” không chỉ là một tranh cãi kỹ thuật. Nó buộc loài người phải nhìn thẳng vào bản chất của AI hiện đại: không phải một trí tuệ đang học hỏi như con người, mà là một hệ thống nén và tái tạo thông tin ở quy mô chưa từng có, đôi khi đến mức có thể khôi phục gần trọn vẹn cả một cuốn sách hay một bài luận từ vài gợi ý ngắn. Khi hiểu đúng điều đó, những câu hỏi về bản quyền, công bằng, và tương lai của sáng tạo trở nên không thể né tránh, đặc biệt khi các vụ kiện như của The New York Times tố GPT‑4 sao chép gần nguyên văn nhiều bài báo cho thấy vấn đề không chỉ nằm trong phòng thí nghiệm mà đã xuất hiện ngay trên sản phẩm thương mại. Có lẽ điều nguy hiểm nhất không phải là việc AI ghi nhớ, mà là việc ngành công nghiệp cố gắng khiến chúng ta tin rằng nó không làm vậy, đồng thời dùng ngôn ngữ “học hỏi”, “sáng tạo” để làm mờ ranh giới giữa nén‑sao chép và hiểu‑sáng tác. Và chỉ khi câu chuyện được kể lại một cách trung thực hơn, xã hội mới có thể đưa ra những quyết định đúng đắn về việc cho phép công nghệ này đi xa đến đâu. Nguồn: [1][2][3][4]
Nguồn thông tin: Tổng hợp và biên tập từ chuyên trang công nghệ.