
Cập nhật các công cụ cho dân làm Data
Bước vào giữa năm 2026, thế giới công nghệ thông tin đã đi qua thời kỳ của những chatbot AI hỏi đáp đơn giản. Đây là kỷ nguyên của Agentic AI (Trí tuệ nhân tạo tự hành), nơi các AI Agents trực tiếp tham gia vào quá trình vận hành hệ thống. Đối với các kỹ sư dữ liệu (Data Engineers), bối cảnh này đang định hình lại toàn bộ bộ công cụ làm việc hằng ngày. Các công cụ quen thuộc như dbt, Apache Airflow, Snowflake hay Databricks không còn là những phần mềm quản lý dòng chảy dữ liệu (Data Pipeline) tĩnh hay chạy theo lịch trình cứng nhắc. Chúng đã lột xác để tích hợp sâu Trí tuệ nhân tạo, tự động hóa toàn diện từ khâu viết code, sửa lỗi hệ thống, đến quản trị rủi ro chất lượng dữ liệu. Bài viết này sẽ cập nhật chi tiết những thay đổi mang tính cách mạng của các công cụ Data Engineering hàng đầu hiện nay.
1. Siêu Sáp Nhập Fivetran & dbt Labs
Sự kiện chấn động nhất thị trường dữ liệu nửa đầu năm 2026 chính là việc hai gã khổng lồ Fivetran và dbt Labs hoàn tất thương vụ sáp nhập lịch sử. Sự kết hợp này nhằm mục đích duy nhất: Xây dựng một hạ tầng dữ liệu mở, thống nhất và đáng tin cậy để làm bệ đỡ cho các AI Agents của doanh nghiệp.
dbt Core v2.0 Và Động Cơ dbt Fusion Engine (Rust-based)
Sự ra đời của dbt Core v2.0 đánh dấu việc mã nguồn mở hóa hoàn toàn động cơ dbt Fusion Engine (vốn được viết lại hoàn toàn bằng ngôn ngữ Rust). Tốc độ biên dịch thần tốc: Nhờ sức mạnh của Rust và khả năng hiểu cú pháp SQL bản địa, dbt Fusion Engine mang lại tốc độ phân tích và biên dịch dự án nhanh gấp $10$ lần so với phiên bản cũ. Tối ưu hóa tài nguyên: Giờ đây, các dự án dữ liệu lớn với hàng nghìn bảng (models) liên kết chồng chéo không còn là nỗi ám ảnh về mặt hiệu năng.
dbt State: Cắt Giảm Chi Phí Hạ Tầng Lên Đến $30\%$
Để giải quyết bài toán chi phí điện toán đám mây (Cloud Compute) đang tăng vọt, dbt Labs đã giới thiệu tính năng dbt State: Thay vì phải xây dựng lại toàn bộ các bảng dữ liệu trong đường ống (lineage) mỗi khi chạy (rebuild), dbt State sẽ đối chiếu siêu dữ liệu (metadata) để kiểm tra xem dữ liệu nguồn hoặc mã nguồn có thay đổi hay không. Nếu không có sự thay đổi, hệ thống sẽ tự động bỏ qua (skip) bước tính toán đó và tái sử dụng trạng thái cũ. Thực tế triển khai tại các doanh nghiệp lớn cho thấy dbt State giúp cắt giảm trung bình từ $30\%$ đến $35\%$ chi phí vận hành kho dữ liệu.
dbt Wizard: Trợ Lý AI Nắm Rõ “Bản Đồ” Hệ Thống
Điểm bứt phá nhất là sự xuất hiện của dbt Wizard – một AI Agent tự hành được xây dựng riêng cho quy trình phân tích và phát triển dữ liệu (Analytics Engineering): Không giống như các trợ lý viết code chung chung (như ChatGPT hay Copilot thông thường) vốn dễ viết sai cấu trúc hoặc tạo ra code rác, dbt Wizard được nhúng trực tiếp vào siêu dữ liệu của toàn bộ dự án. dbt Wizard hiểu rõ mối quan hệ giữa các bảng (lineage), các điều khoản ràng buộc dữ liệu (contracts), các bài kiểm tra chất lượng (tests) và định nghĩa chỉ số (metrics). Khi kỹ sư yêu cầu viết một bảng mới, dbt Wizard sẽ tự động viết các câu lệnh JOIN chuẩn xác, tự động tạo các bài test chất lượng dữ liệu và cảnh báo trước cho kỹ sư nếu đoạn code mới có nguy cơ làm hỏng (break) các báo cáo Dashboard ở hạ tầng cuối nguồn (downstream).
2. Apache Airflow 3.0 và Sức Mạnh Của “Common AI Provider”
Được phát hành chính thức vào nửa sau năm 2025 và nhanh chóng đạt tỷ lệ chấp nhận kỷ lục hơn $26\%$ trong các doanh nghiệp lớn vào năm 2026, Apache Airflow 3 chính là operational backbone (xương sống vận hành) cho toàn bộ hệ thống dữ liệu lớn và AI workloads hiện đại.
Gói Tích Hợp “Common AI Provider” Bản Địa
Không còn dừng lại ở việc lập lịch cho các tác vụ tính toán thông thường, Airflow 3 đã ra mắt gói tích hợp bản địa dành riêng cho LLMs và AI Agents mang tên Common AI Provider: HookToolset – Biến 350+ cổng kết nối thành công cụ cho AI: Airflow nổi tiếng với hơn $350$ cổng kết nối (hooks) bảo mật kết nối với AWS, Google Cloud, Snowflake, Slack… Gói Common AI Provider cho phép lập trình viên biến toàn bộ các hooks này thành các công cụ định dạng (tools) cho AI Agent sử dụng một cách an toàn thông qua cơ chế phân quyền chặt chẽ. Xây dựng Agentic DAGs: AI Agent chạy trong Airflow có thể tự động suy luận và sử dụng các công cụ này để thực thi nhiệm vụ phức tạp. Ví dụ, AI Agent nhận thấy một file dữ liệu mới xuất hiện trên AWS S3, nó sẽ tự động dùng công cụ đọc file, tự động viết câu lệnh truy vấn nộp lên Snowflake, nhận kết quả và tự động gửi thông báo báo cáo qua Slack cho sếp.
Tính Năng “Human-In-The-Loop” (Trình Phê Duyệt Của Con Người)
Hình ảnh minh họa cho Cập nhật các công cụ cho dân làm Data. Ảnh: Tư liệu
3. Snowflake Và Databricks: Cuộc Chiến Trên Lớp Siêu Dữ Liệu (Metadata)
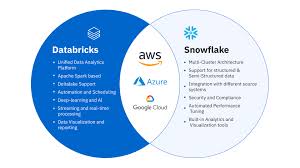
Cuộc đua song mã giữa hai gã khổng lồ Snowflake (Đại diện Cloud Data Warehouse) và Databricks (Đại diện Cloud Data Lakehouse) đã chính thức hội tụ về mặt kiến trúc trong năm 2026.
Sự Thống Trị Của Định Dạng Bảng Mở (Open Table Formats)
Cuộc chiến về mặt lưu trữ đã ngã ngũ khi cả hai bên đều chấp nhận Apache Iceberg như một tiêu chuẩn lưu trữ chung. Doanh nghiệp giờ đây chỉ cần lưu dữ liệu một lần duy nhất dưới dạng Iceberg trên Cloud, và có thể tùy ý dùng Snowflake, Databricks hay Apache Spark để truy vấn chéo mà không cần di chuyển dữ liệu.
SnowConvert AI Và Cortex AI Functions Của Snowflake
Snowflake đã tung ra bản cập nhật lớn cho SnowConvert AI: Sử dụng hệ thống tác tử AI thông minh để tự động phân tích và chuyển đổi các câu lệnh SQL cổ điển, các thủ tục lưu trữ (Stored Procedures) từ các hệ thống cũ (như SQL Server, Teradata) sang môi trường đám mây một cách hoàn toàn tự động. Tích hợp cơ chế xác thực hai bên (Two-sided verification): AI tự động chạy thử nghiệm đoạn code đã chuyển đổi trên cả hệ thống cũ và hệ thống mới bằng dữ liệu giả lập (synthetic data), đối chiếu kết quả, và nếu phát hiện sai lệch, AI Agent sẽ tự động sửa đổi logic cho đến khi khớp hoàn toàn mới bàn giao cho kỹ sư. Bên cạnh đó, dịch vụ Cortex AI Functions của Snowflake đã bổ sung các mô hình đa phương tiện (như Gemini 3.5 Flash), cho phép kỹ sư dữ liệu viết trực tiếp các câu lệnh SQL để AI phân tích video, âm thanh và hình ảnh ngay bên trong kho dữ liệu mà không cần di chuyển dữ liệu ra ngoài.
Hình ảnh minh họa cho Cập nhật các công cụ cho dân làm Data. Ảnh: Tư liệu
4. Trực Quan Hóa Và Quan Sát Dữ Liệu (Data Observability) Tự Động Bằng Học Máy
Chất lượng dữ liệu luôn là nỗi đau lớn nhất của mọi doanh nghiệp. Khi AI tham gia sâu vào vận hành, một dữ liệu “bẩn” (như thiếu cột, lệch định dạng thời gian) có thể dẫn đến việc các mô hình dự báo AI đưa ra các quyết định thảm họa. Năm 2026, các nền tảng quan sát dữ liệu (như Monte Carlo) đã tích hợp sâu các mô hình Học máy (Machine Learning) để chuyển đổi từ cơ chế giám sát thụ động sang Giám sát chủ động (Proactive Monitoring): Học máy tự nhận diện trạng thái bình thường (Anomalies Detection): Hệ thống AI sẽ tự học lịch sử dòng chảy dữ liệu của doanh nghiệp để tự động định nghĩa xem thế nào là dữ liệu “chuẩn” (mật độ cập nhật, số lượng dòng, phân phối giá trị). Tự động vá lỗi và cảnh báo sớm: Nếu hệ thống nguồn bỗng dưng gửi dữ liệu thiếu cột hoặc sai định dạng múi giờ vào lúc 2 giờ sáng, AI sẽ lập tức phát hiện, cô lập dòng dữ liệu lỗi đó (quarantine) để không làm hỏng các báo cáo Dashboard của ban giám đốc, đồng thời tự động gửi ticket cảnh báo chi tiết nguyên nhân lỗi cho đội ngũ trực ca.
Hình ảnh minh họa cho Cập nhật các công cụ cho dân làm Data. Ảnh: Tư liệu
5. Kỹ Sư Dữ Liệu Thời Đại Agentic AI
Những bước tiến vượt bậc của các công cụ Data Engineering trong năm 2026 đang truyền đi một thông điệp rõ ràng: Công việc kỹ thuật cơ bắp (như viết code ETL thủ công, cấu hình server vật lý) đang được tự động hóa triệt để bởi AI Agents.
Nguồn thông tin: Tổng hợp và biên tập từ chuyên trang công nghệ.