
Dựng harness cho AI local: chia sẻ từ kinh nghiệm của mình, model có thể nhỏ nhưng hiệu quả thì to
Trong bài viết này, Sharevina.com xin chia sẻ đến quý độc giả những phân tích và cập nhật mới nhất về chủ đề: Dựng harness cho AI local: chia sẻ từ kinh nghiệm của mình, model có thể nhỏ nhưng hiệu quả thì to. Đây là những thông tin đáng chú ý, được tổng hợp và chọn lọc kỹ lưỡng nhằm mang đến góc nhìn đa chiều, thiết thực và có giá trị tham khảo cao.
Hình ảnh minh họa cho Dựng harness cho AI local: chia sẻ từ kinh nghiệm của mình, model có thể nhỏ nhưng hiệu quả thì to. Ảnh: Tổng hợp
Ở phần 1 mình đã nói harness là gì và vì sao cùng một model nhưng đặt vào harness khác nhau thì kết quả nó khác nhau rất nhiều. Phần 2 này thực tế hơn, câu hỏi mình muốn trả lời là khi anh em bắt tay vào tự dựng harness cho model chạy trên máy tính cá nhân, có những nguyên tắc nào mà giao cho AI việc gì đi nữa cũng phải cần những bước này? Mỗi người một nhu cầu nên trong bài mình sẽ dùng lại mấy ví dụ quen thuộc từ phần 1 như đọc ảnh hóa đơn thành bảng chi tiêu, tóm tắt ghi âm cuộc họp, soạn thư trả lời khách hàng. Mình thêm một ví dụ ở mảng sáng tạo nội dung là viết bài giới thiệu sản phẩm từ tài liệu có sẵn, vì đây là loại việc khó biết đúng sai nhất. Code chạy hay không chạy nhìn qua là biết liền, còn một bài viết đọc “có vẻ ổn” thì lỗi lọt qua lúc nào không hay.
Hình ảnh minh họa cho Dựng harness cho AI local: chia sẻ từ kinh nghiệm của mình, model có thể nhỏ nhưng hiệu quả thì to. Ảnh: Tổng hợp
Thế nào là xong?
Phần lớn mọi người khi mới bắt đầu sẽ viết prompt trước, kiểu “hãy viết bài giới thiệu sản phẩm này, giọng thân thiện, dài khoảng 800 chữ”. Model trả về một bài đọc cũng được, nhưng anh em không biết nó đúng hay sai ở đâu, ngoài cảm giác ra thì không có gì để chấm cả. Nên anh em cần viết ra danh sách “thế nào là xong” trước, rồi với từng tiêu chí thì xem nên để code kiểm, để một lượt gọi model khác chấm, hay phải để người kiểm. Lấy ví dụ đọc hóa đơn đi, có cái code kiểm được như tổng các dòng có khớp số tổng in trên hóa đơn không, ngày có đúng định dạng không, ô nào bị bỏ trống. Có cái phải nhờ một lượt gọi model khác đọc và chấm, như món hàng có được xếp đúng nhóm chi tiêu không. Với thư trả lời khách hàng thì còn có cái chỉ con người mới biết được, như giọng thư có hợp với khách này không, có hứa điều gì mà công ty không làm được không.
Hình ảnh minh họa cho Dựng harness cho AI local: chia sẻ từ kinh nghiệm của mình, model có thể nhỏ nhưng hiệu quả thì to. Ảnh: Tổng hợp
Có nên đưa hết cho model xử lý?
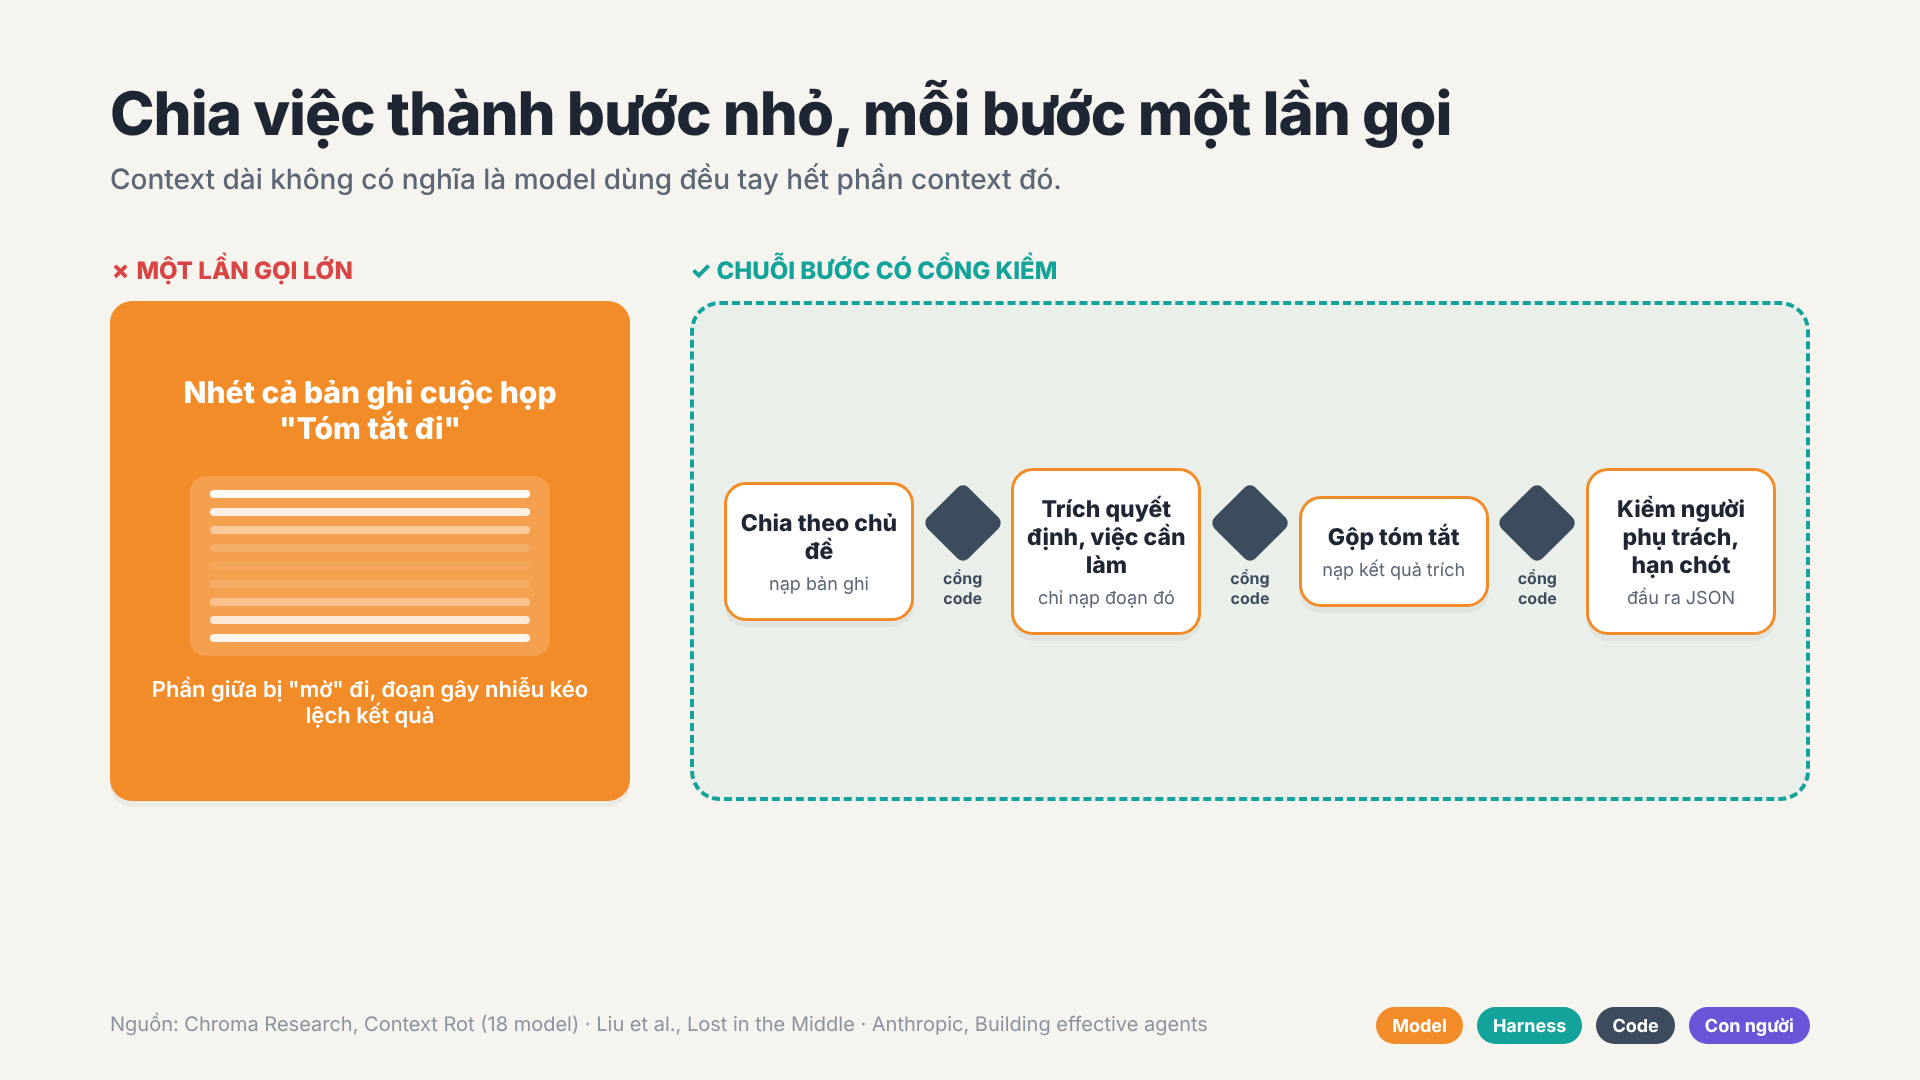
Chroma đã thử 18 model và kết luận là đầu vào càng dài thì model chạy càng thiếu ổn định, kể cả với việc rất đơn giản như chép lại một chuỗi từ. Họ còn cho thấy chỉ cần thêm một đoạn “gây nhiễu” (distractor) na ná câu trả lời là kết quả đã kém đi, đầu vào càng dài thì model càng dễ lấy nhầm đoạn gây nhiễu đó làm câu trả lời. Anthropic gọi hiện tượng này là “context rot” và khuyên nên xem context là tài nguyên có hạn, chỉ nạp đúng phần thông tin cần thiết thôi. Nghiên cứu “Lost in the Middle” mình nhắc ở phần 1 cũng cho thấy model hay bỏ sót thông tin nằm ở giữa một đầu vào dài. Lấy ví dụ tóm tắt ghi âm một cuộc họp giao ban đi. Thay vì nhét cả bản ghi vào rồi bảo “tóm tắt đi”, anh em có thể chia việc ra làm bốn bước. Bước đầu chia bản ghi theo từng chủ đề. Bước hai đọc từng đoạn và trích ra quyết định, việc cần làm. Bước ba gộp mấy phần đã trích thành bản tóm tắt. Bước cuối kiểm xem việc nào đã có người phụ trách và hạn chót. Mỗi bước là một lần gọi model riêng và chỉ nạp đúng phần thông tin bước đó cần. Xong mỗi bước thì code kiểm kết quả trước, đạt mới cho chạy bước sau, giống một cái cổng kiểm. Cách làm này có tên là prompt chaining. Nhưng chia nhỏ quá cũng có cái giá của nó, mình sẽ nói ở phần các kiểu lỗi bên dưới.
Hình ảnh minh họa cho Dựng harness cho AI local: chia sẻ từ kinh nghiệm của mình, model có thể nhỏ nhưng hiệu quả thì to. Ảnh: Tổng hợp
Việc nào code làm, việc nào model làm?
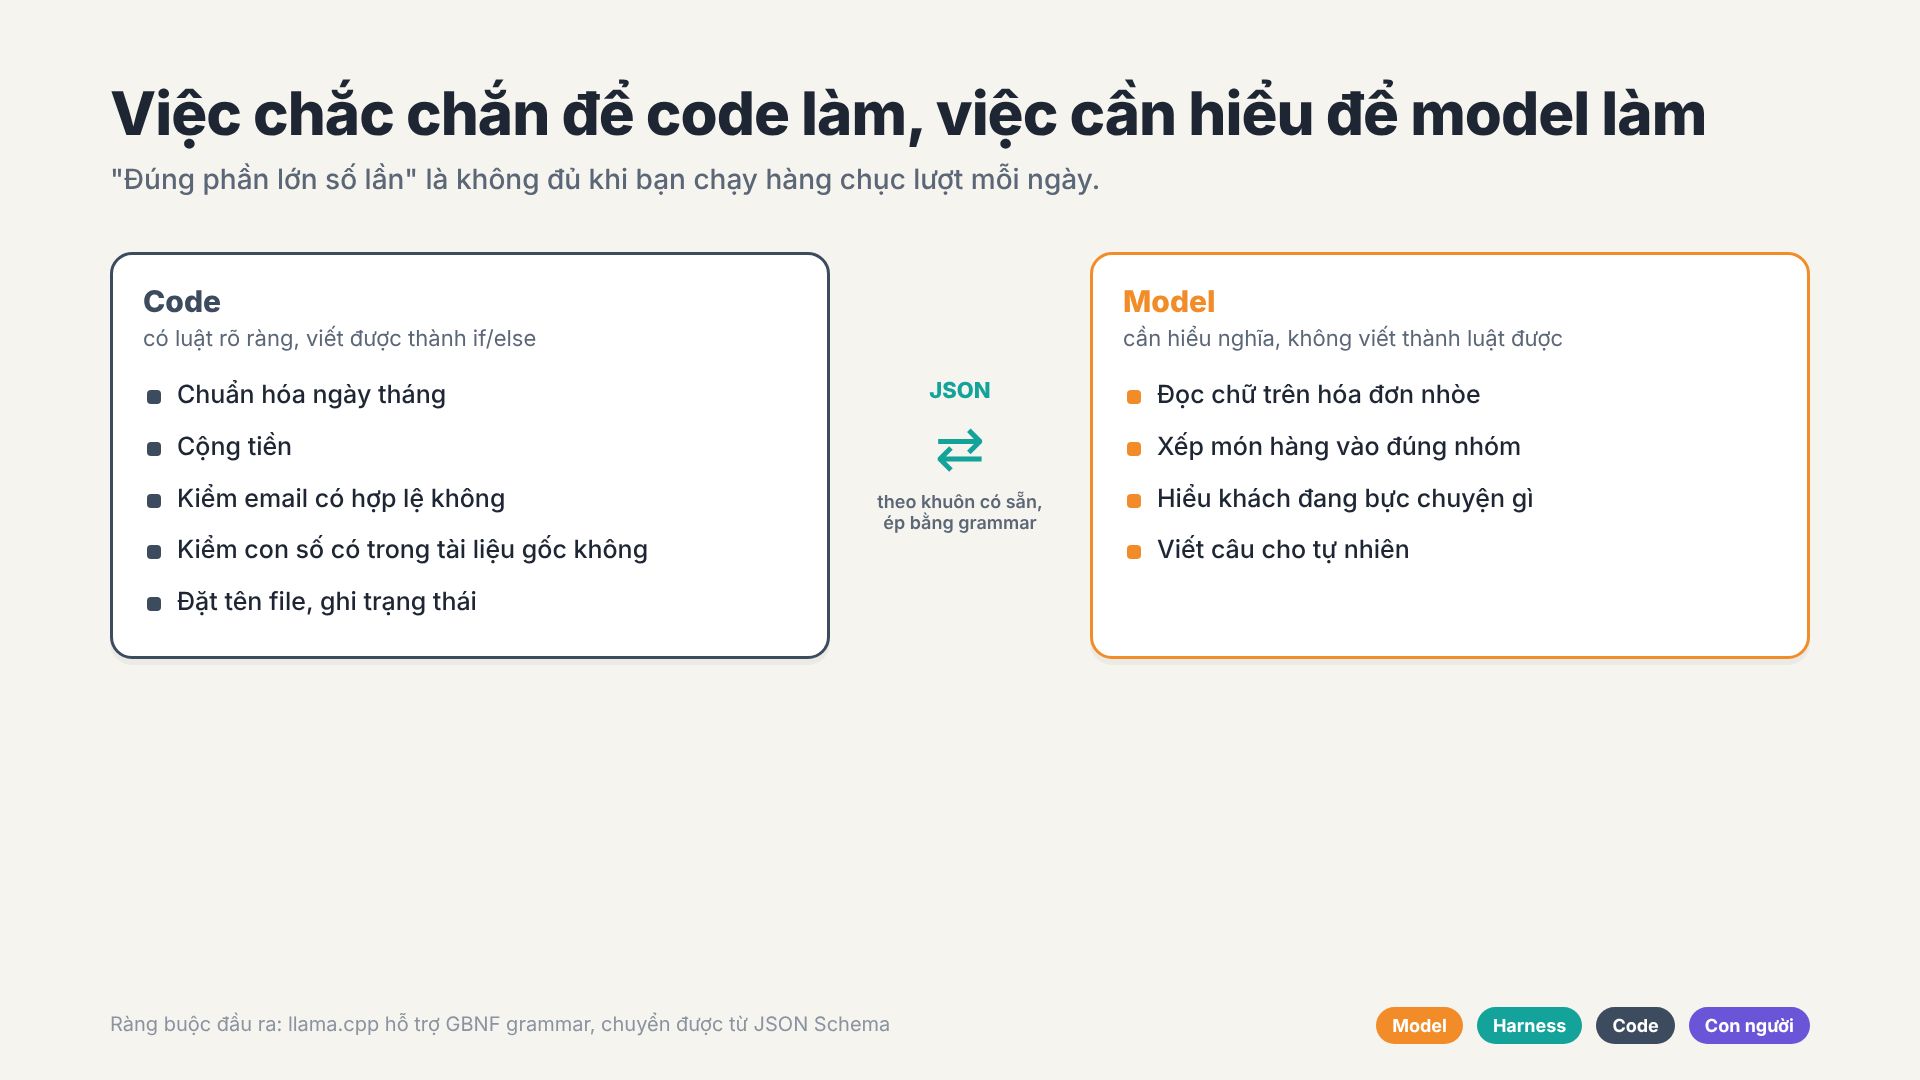
Việc gì viết được thành luật rõ ràng thì đừng nhờ model, kể cả khi model làm được. Chuẩn hóa ngày tháng về một định dạng, cộng tiền, kiểm một địa chỉ email có hợp lệ không, kiểm một con số có nằm trong tài liệu gốc không, đặt tên file… mấy việc này code làm đúng 100% số lần. Model thì đúng phần lớn thôi, mà chạy hàng chục lượt mỗi ngày thì “phần lớn” nó nguy hiểm lắm.
Hình ảnh minh họa cho Dựng harness cho AI local: chia sẻ từ kinh nghiệm của mình, model có thể nhỏ nhưng hiệu quả thì to. Ảnh: Tổng hợp
Model chỉ nên làm việc cần hiểu nghĩa, như đọc chữ trên một tấm hóa đơn nhòe, xếp món hàng vào đúng nhóm, hiểu khách đang bực chuyện gì, viết câu cho tự nhiên. Ranh giới giữa việc dùng code hay model nhiều khi không rõ ràng, nhưng mình có một cách thử đơn giản là nếu anh em giải thích được việc đó bằng vài dòng if/else thì để code làm. Còn những việc code phải đoán theo dấu hiệu, chẳng hạn tự xóa dòng trùng trong hóa đơn, thì nên đặt luật thật chặt, không chắc thì để nguyên. Bỏ sót một lỗi thì bước sau anh em còn bắt lại được, chứ sửa nhầm một chỗ đúng thành sai thì không ai biết mà tìm.
Hình ảnh minh họa cho Dựng harness cho AI local: chia sẻ từ kinh nghiệm của mình, model có thể nhỏ nhưng hiệu quả thì to. Ảnh: Tổng hợp
Bắt model trả lời theo khuôn
Đầu ra của bước này là đầu vào của bước sau thì đừng để model trả lời bằng text thông thường. Bắt nó trả về dạng file JSON theo một cấu trúc cố định, ví dụ mỗi dòng hóa đơn là một đối tượng có tên món, số lượng, đơn giá, nhóm chi tiêu. Code đọc JSON thì chắc ăn, còn để code đi “đoán” ý trong một đoạn văn thì khả năng mắc sai lầm là rất lớn. Với model local thì llama.cpp hỗ trợ grammar (ngữ pháp ràng buộc, định dạng GBNF), chuyển được từ JSON Schema sang, ép model chỉ sinh ra token đúng với cấu trúc anh em định nghĩa. Anthropic cũng có một quan sát khá hay là model ít tự ý sửa hay ghi đè file JSON hơn file Markdown, nên những thứ quan trọng như danh sách việc cần làm hay trạng thái từng bước thì lưu bằng JSON cho an toàn.
Các kiểu lỗi hay gặp
Đây là mấy kiểu lỗi mà khi anh em dựng harness nào cũng nên chặn từ đầu, vì nó không nằm ở chỗ anh em hay để ý.
Model tự nhận trải nghiệm hay số liệu không phải của nó
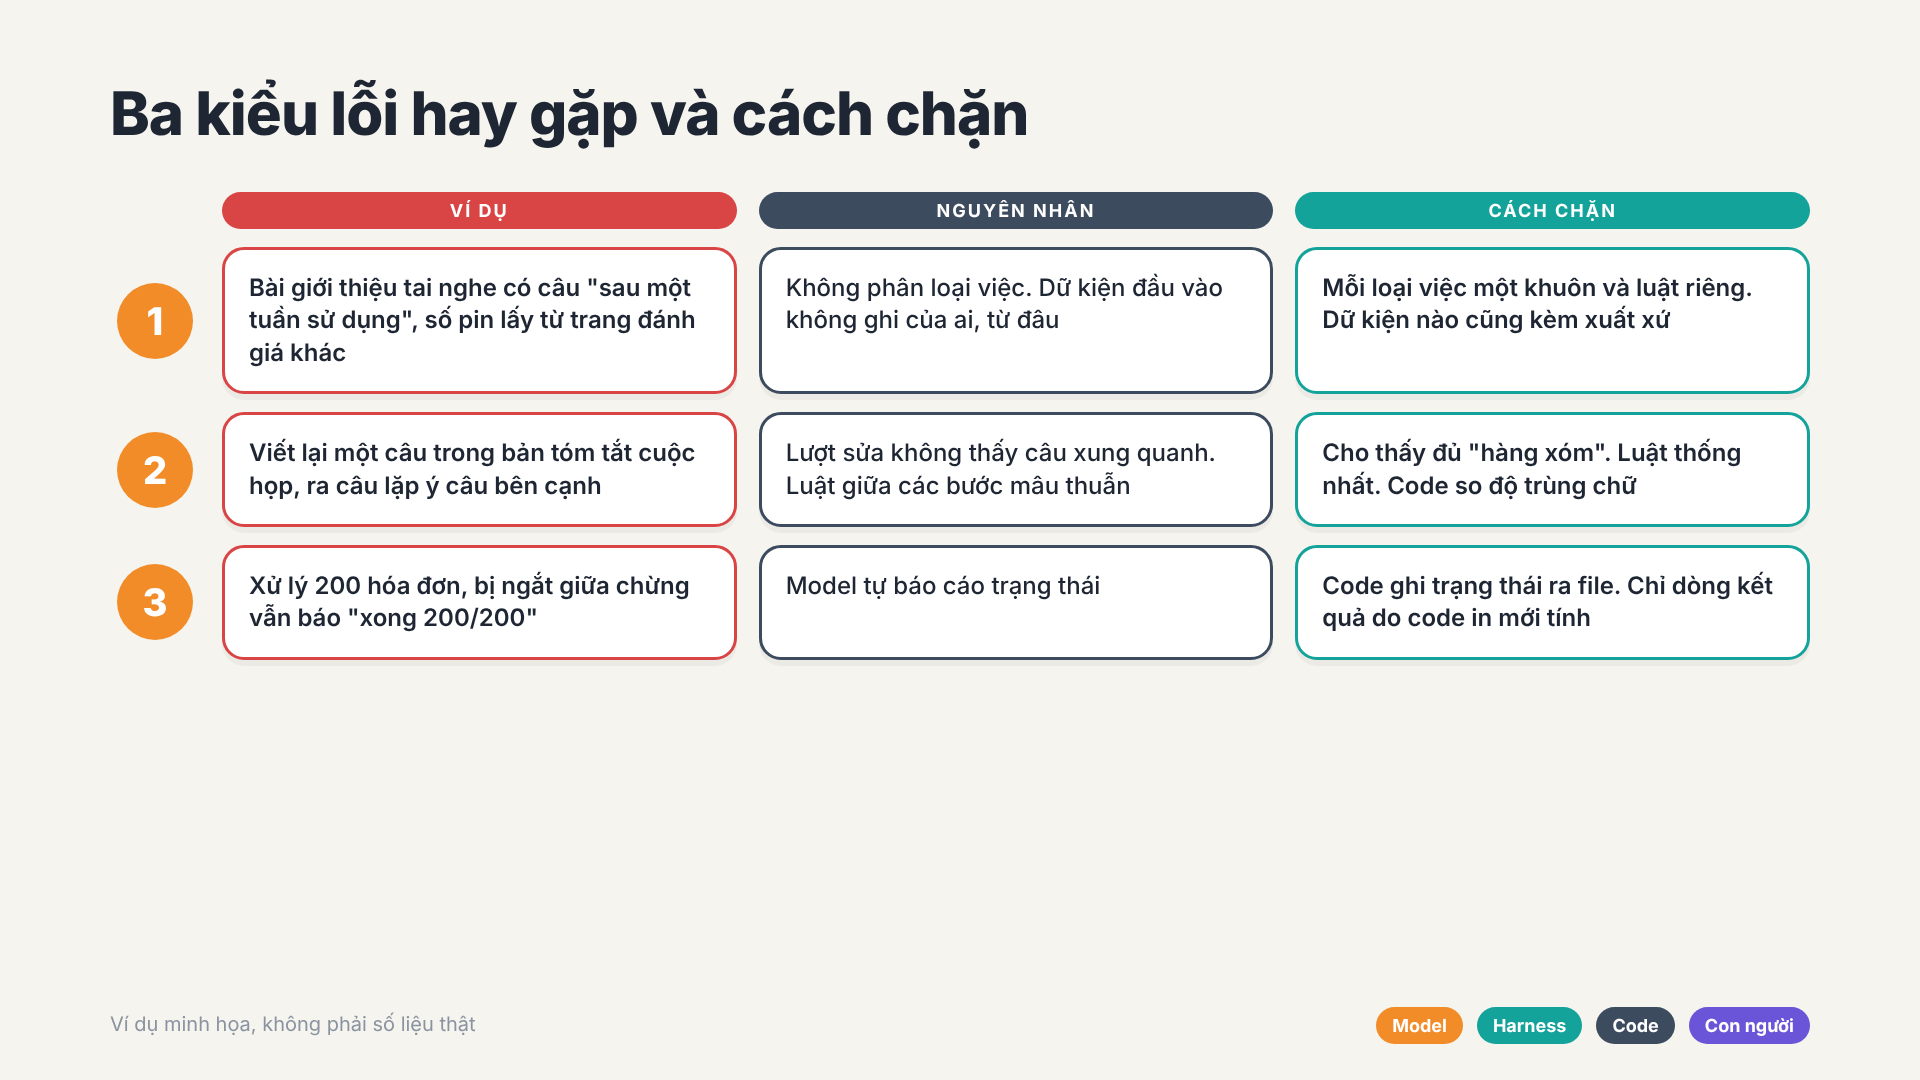
Giả sử anh em đưa cho model tài liệu kỹ thuật của một chiếc tai nghe kèm vài bài đánh giá của trang khác, nhờ viết bài giới thiệu (cái này mấy anh em cửa hàng hay dùng để viết mô tả của sản phẩm, bài giới thiệu nhanh…). Bài trả về có câu “sau một tuần sử dụng, pin trụ được gần hai ngày”, đọc như thể người viết đã tự dùng, trong khi con số đó là của một trang đánh giá. Bước kiểm “số liệu lạ” cũng không bắt được, vì con số đúng là có trong tài liệu. Cách chặn là khai báo rõ loại việc, mỗi loại có khuôn và luật riêng, bài giới thiệu từ tài liệu thì không được có câu trải nghiệm và dữ kiện nào trong đầu vào cũng phải ghi kèm xuất xứ, số này của ai, câu này lấy từ đâu. Thiếu xuất xứ thì model sẽ tự lấp chỗ trống, mà nó lấp theo hướng cho câu văn xuôi tai chứ không theo hướng đúng sự thật.
Bước sửa lỗi lại sinh ra lỗi mới
Ví dụ trong bản tóm tắt cuộc họp có một câu mà bước kiểm thấy không có trong bản ghi, nghĩa là model tự thêm vào. Harness tách riêng câu đó ra, đưa cho model viết lại. Vấn đề là lúc này model chỉ thấy mỗi câu đó với bản ghi, không thấy mấy câu trước sau, nên nó rất dễ viết lại thành đúng cái ý mà câu kế bên đã nói rồi. Sửa xong một lỗi thì bản tóm tắt lại bị lặp ý. Còn một kiểu nữa là luật của các bước đá nhau. Bước viết thì được dặn “giải thích cho dễ hiểu”, tới bước kiểm lại coi câu giải thích nào cũng là thêm thắt, thế là viết ra bao nhiêu thì bị gạch bấy nhiêu. Cách chặn thì có ba cách. Khi đưa một câu cho model sửa thì đưa kèm mấy câu xung quanh để nó biết đã có ý gì rồi. Luật của các bước phải đọc chung với nhau, đừng để bước này cấm cái bước kia yêu cầu. Cuối cùng cho code dò lại xem có câu nào giống nhau quá không.
Model báo cáo sai trạng thái
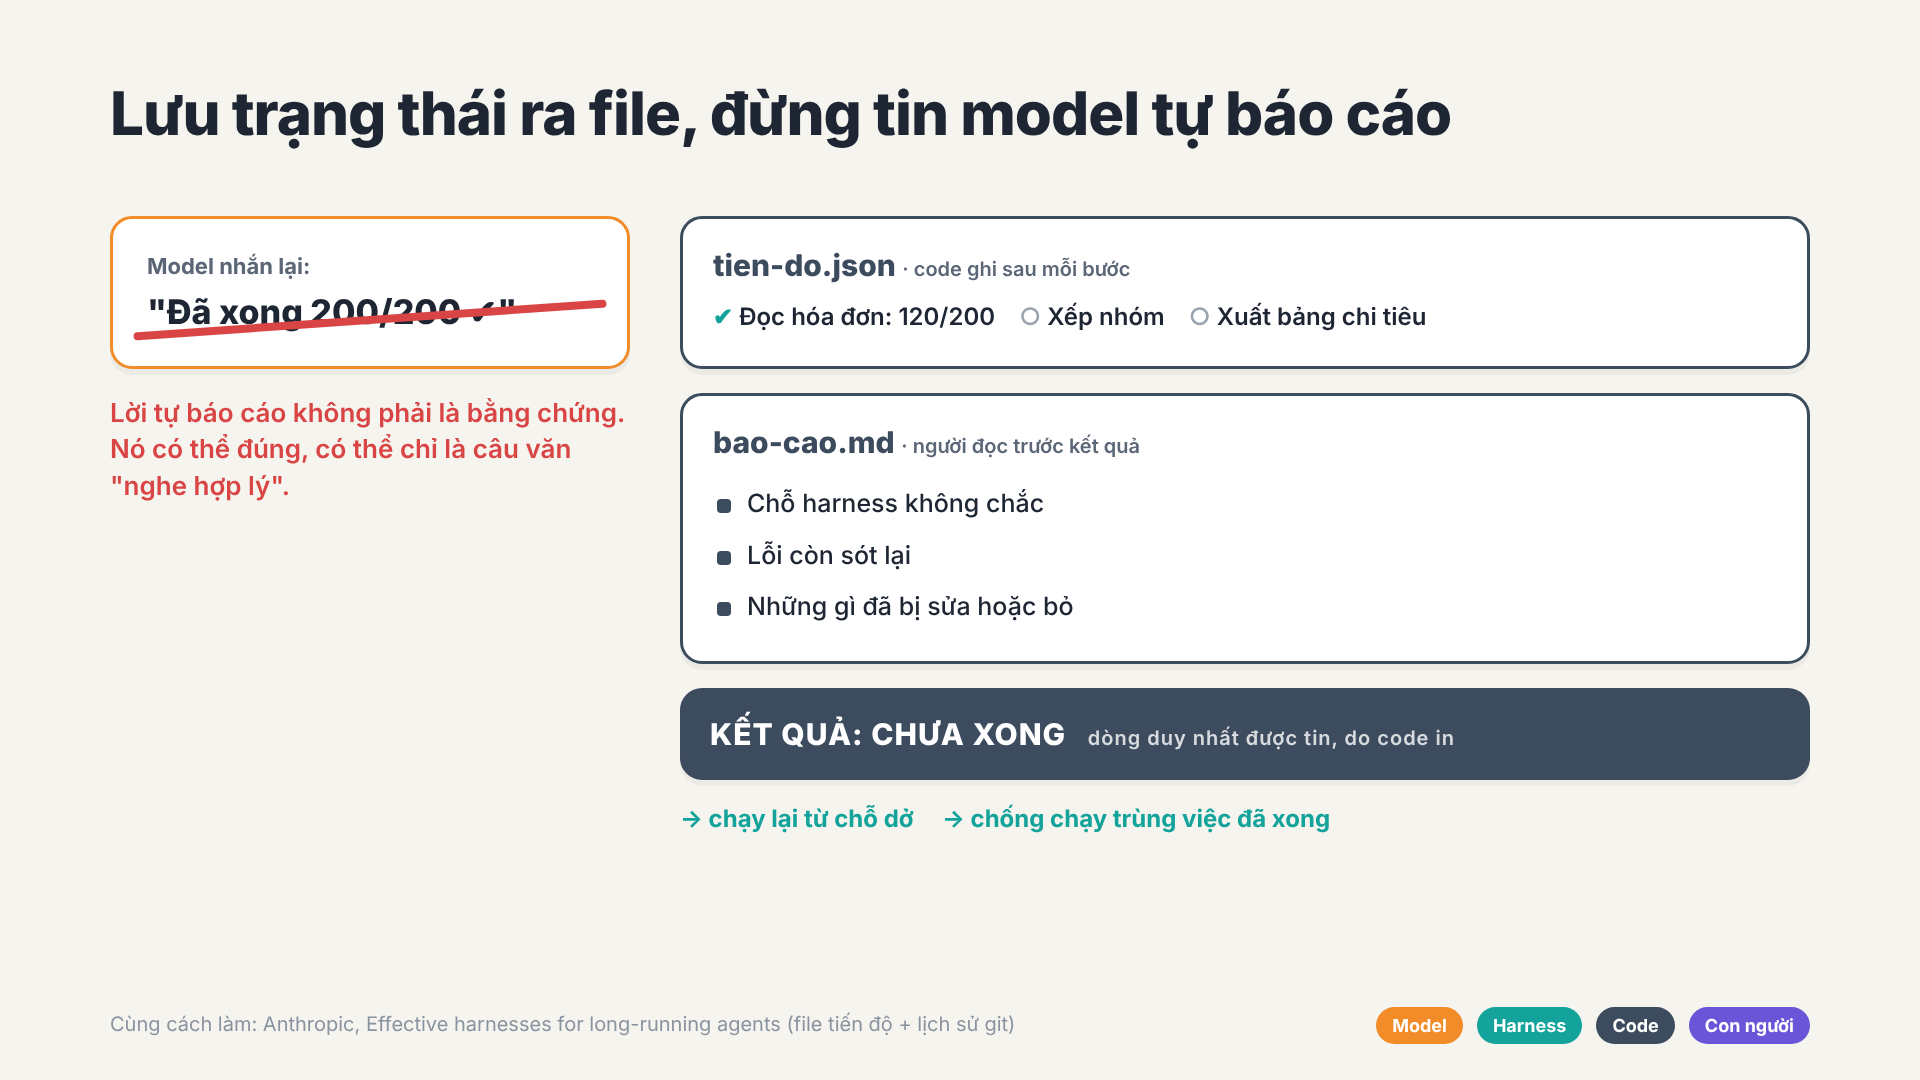
Giả sử agent được giao xử lý 200 tấm hóa đơn, chạy được nửa chừng thì tác vụ bị ngắt vì quá thời gian cho phép. Vậy mà nó vẫn có thể nhắn lại là “đã xử lý xong 200/200”, kèm luôn con số kiểm tra nhìn rất thuyết phục. Mình thấy đây là kiểu lỗi đáng sợ nhất, vì nội dung không sai mà cái báo cáo sai, tin báo cáo là anh em không mở ra kiểm nữa. Cách chặn là không tin model tự báo cáo trạng thái, trạng thái phải do code ghi ra file, chỉ dòng kết quả do code in ra mới tính.
Đừng để model tự kiểm tra kết quả của chính nó
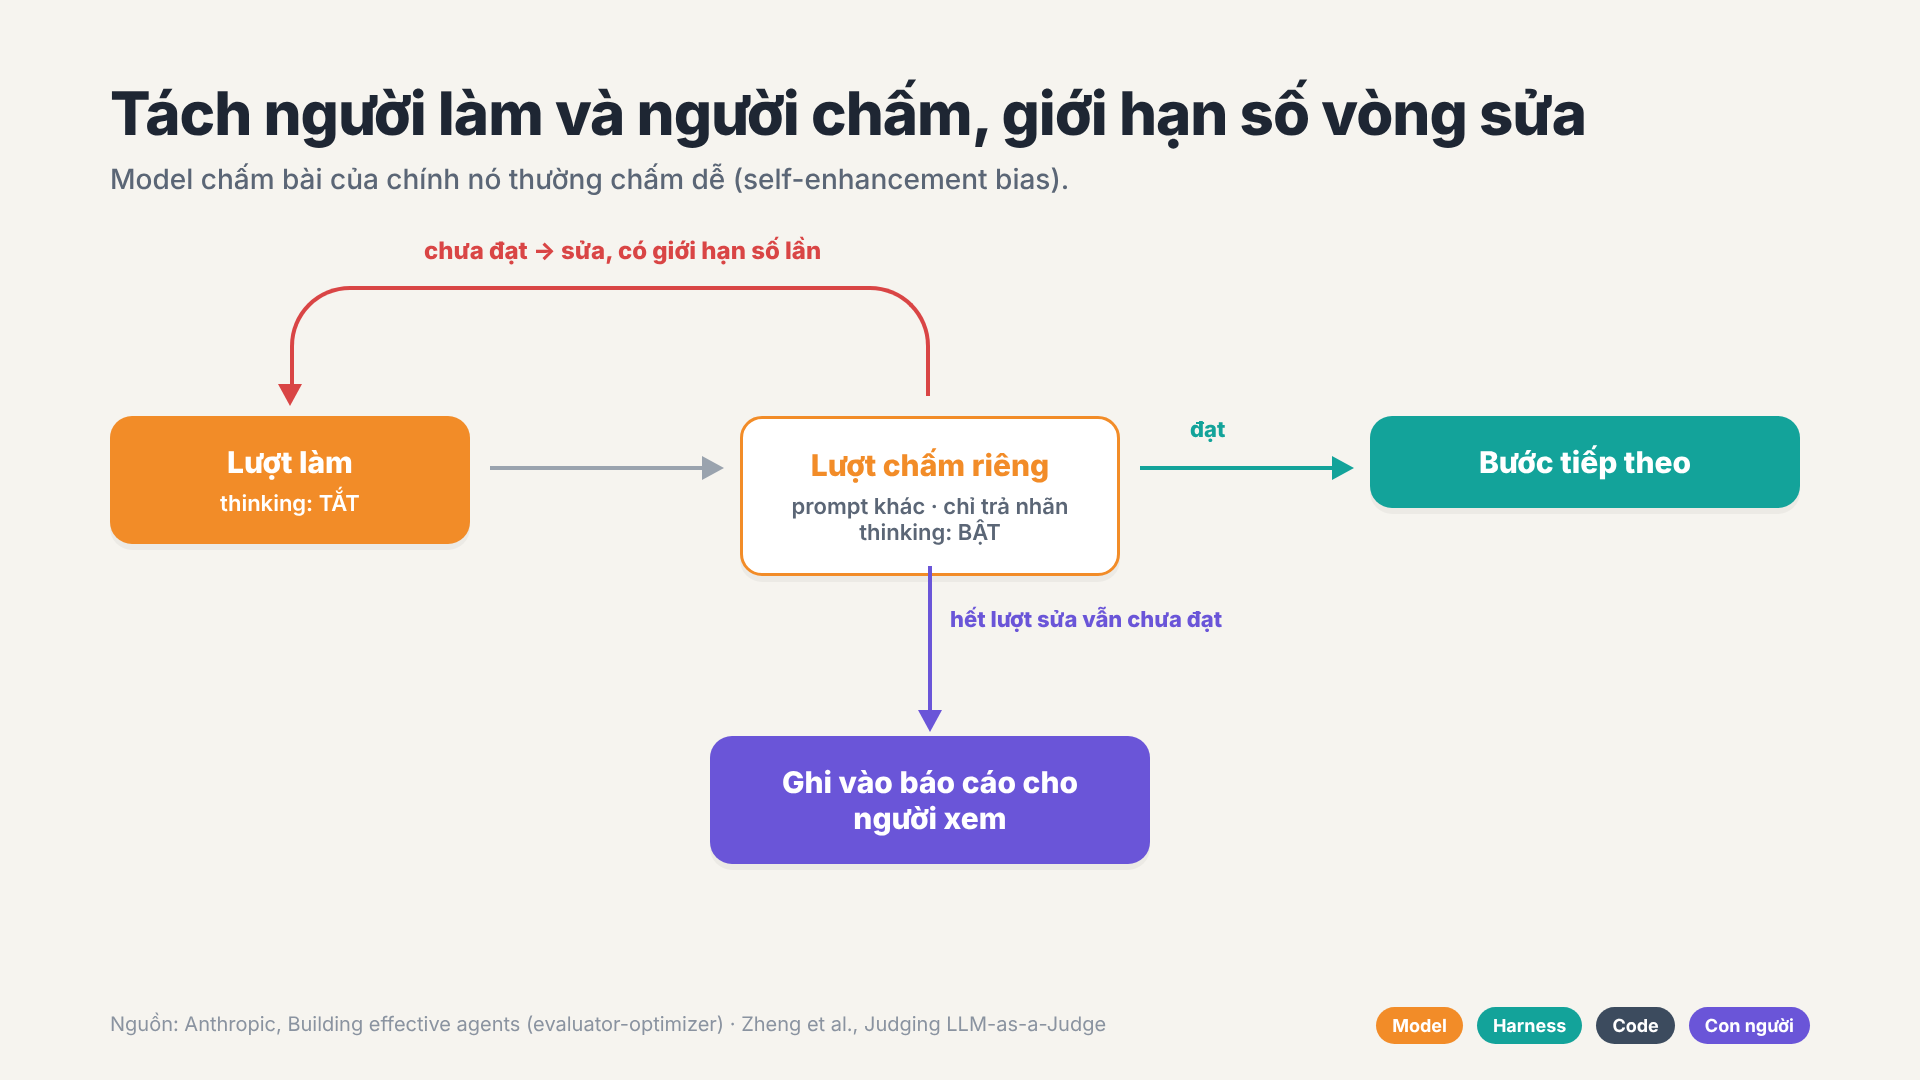
Một lượt gọi model vừa viết vừa tự chấm thì thường chấm dễ lắm. Nghiên cứu “Judging LLM-as-a-Judge” của nhóm LMSYS gọi cái này là self-enhancement bias (thiên vị bản thân), model làm giám khảo có xu hướng ưu ái câu trả lời do chính nó viết ra. Nên tách hẳn một lượt gọi riêng chỉ để chấm, prompt khác, nhiệm vụ khác, chỉ trả về nhãn chứ không được sửa. Đây là mẫu evaluator-optimizer (một bên làm, một bên chấm) mà Anthropic có nói tới. Mỗi lượt làm và chấm cũng phải có giới hạn số lần. Sửa đủ số lần mà chưa xong thì code dừng, ghi lỗi vào báo cáo cho người xem chứ không cho model sửa mãi. Với model nhỏ, để nó lặp không giới hạn thì kết quả không tốt lên mà cứ trôi dần đi chỗ khác. Thêm một mẹo với model có chế độ suy luận (thinking) là bật suy luận ở bước chấm và tắt ở bước viết. Bước chấm cần cẩn thận, chậm chút cũng được. Còn bước viết mà bật lên thì vừa lâu vừa chưa chắc văn hay hơn.
Lưu trạng thái ra file
Cái này nối tiếp kiểu lỗi thứ ba, ví dụ như về tiến độ, đã xử lý xong bao nhiêu tấm hóa đơn, đã xong bước nào, phải được code ghi ra file sau mỗi bước. Cái lợi đầu tiên là chạy lại được từ chỗ bị vấn đề chứ không phải làm lại từ đầu, quan trọng lắm với model local vì nó chạy chậm hơn dịch vụ đám mây nhiều. Lợi thứ hai là chống chạy trùng, việc nào có kết quả rồi thì lần sau chỉ trả lại kết quả cũ, trừ khi được bảo làm mới.
Anthropic cũng làm vậy với agent lập trình của họ, phiên nào cũng đọc file tiến độ và lịch sử git trước khi làm, xong phiên thì ghi lại đã làm gì. Nói vui thì agent khỏi cần trí nhớ, trí nhớ nằm trên ổ cứng rồi. Bên cạnh file tiến độ, mỗi lần chạy nên có thêm một file báo cáo cho người xem, ghi những chỗ harness không chắc, những lỗi còn sót, những gì đã bị sửa hay bỏ. Người dùng đọc file này trước sẽ biết nên soi chỗ nào trong kết quả.
Rào chắn và con người phải là người kiểm duyệt cuối cùng
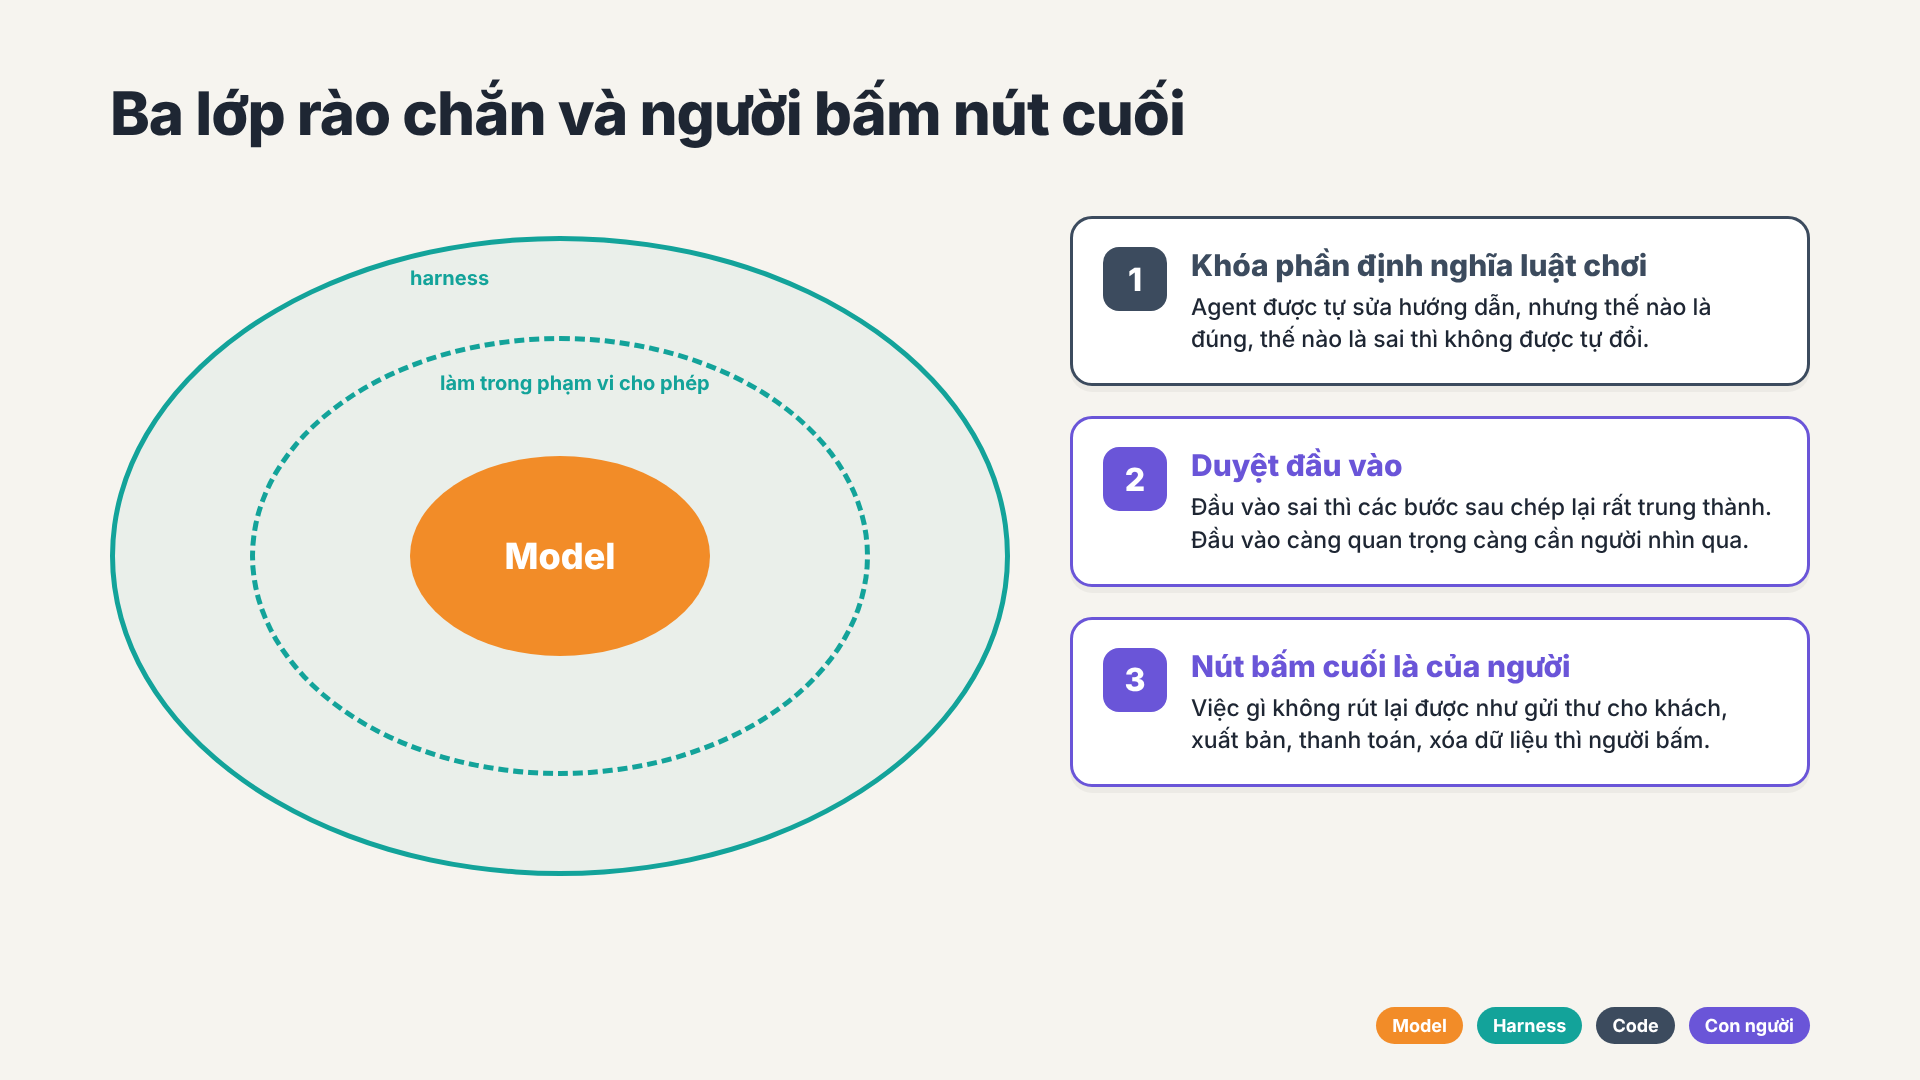
Với mình thì harness nào cũng cần ba lớp rào mà lớp đầu tiên là khóa phần định nghĩa “luật chơi”. Nhiều agent framework bây giờ cho agent tự sửa hướng dẫn của nó sau mỗi lần làm việc (Ví dụ Hermes Agent chẳng hạn). Tính năng này có ích, nhưng phần định nghĩa thế nào là đúng, thế nào là sai thì không nên để agent tự đổi, nếu không thì có ngày nó tự “nới” luật cho dễ thở. Lớp thứ hai là duyệt đầu vào. Đầu vào sai thì các bước sau coi như đi luôn, các bước rà soát lại so với nguồn cũng không biết được vì “nguồn” sai từ đầu rồi. Đầu vào càng quan trọng thì càng nên có người nhìn qua trước khi cho agent chạy. Lớp thứ ba là kiểm duyệt cuối cùng phải luôn là của người. Model chuẩn bị được gần hết, nhưng việc gì không thể tự làm được và không thể thu hồi như gửi thư cho khách, xuất bản, thanh toán, xóa dữ liệu… đều cần bàn tay con người.
Test bằng benchmark để kiểm thử harness
Mỗi lần anh em sửa harness để chặn một lỗi thì rất dễ sinh ra lỗi khác mà không biết. Muốn biết thì phải có một bộ bài thử cố định, gồm những đầu vào tiêu biểu kèm kết quả mà anh em coi là đúng, sửa xong là chạy lại để so.
Hamel Husain, người chuyên tư vấn đánh giá sản phẩm AI, chia việc đánh giá ra ba cấp. Cấp một là kiểm tra bằng code, nhanh, rẻ, sửa xong chạy được liền. Cấp hai là người và model chấm trên đầu ra thật đã lưu lại. Cấp ba là thử nghiệm A/B trên người dùng. Harness cá nhân thì hai cấp đầu là đủ. Lời khuyên mình thấy đáng nhớ nhất của ông là phải đọc thật nhiều đầu ra, đọc tới khi không còn học thêm được gì mới. Nhiều lỗi chỉ lộ ra khi ngồi đọc chứ không hiện lên trong con số và gặp lỗi mới nào thì thêm luật, thêm luôn trường hợp đó vào bộ bài thử để lỗi không quay lại.
Riêng với anh em chạy model local
Có vài thứ chỉ anh em chạy model trên máy tính cá nhân mới gặp. Thứ nhất, khi nhiều ứng dụng dùng chung một máy chủ model như llama.cpp thì các lượt gọi sẽ chia nhau số slot và bộ nhớ KV cache (bộ nhớ đệm phần ngữ cảnh đã xử lý). Tính trước xem có bao nhiêu việc chạy cùng lúc, mỗi việc cần context bao nhiêu, đừng để một ứng dụng chiếm hết. Thứ hai, giữ system prompt cố định giữa các lượt gọi cùng loại. Server như llama.cpp tái sử dụng được phần đầu giống nhau đã xử lý trước đó, system prompt càng ít đổi thì mỗi lượt gọi càng nhanh. Phần nào thay đổi theo từng lượt thì để ở cuối. Thứ ba, model càng nhỏ thì luật càng phải cụ thể. Model lớn trên đám mây hiểu được câu “viết tự nhiên như người thật”, còn model local cỡ trung thì cần ví dụ cụ thể hơn nhiều.
Tạm kết
Cá nhân mình thấy dựng harness giống dạy một người mới vào nghề hơn là viết phần mềm. Model không thiếu khả năng, nó thiếu mấy cái luật mà chính anh em biết rõ nhất. Việc của harness là viết mấy luật đó ra, kiểm bằng code và đừng tin tuyệt đối vào nó. Cá nhân mình khi dựng harness để chạy agent cho các công việc của mình, mình được nhiều nhất chính là độ chính xác của các công việc agent làm nó cải thiện hơn nhiều so với trước đây. Nó đến từ việc mình muốn hạn chế sử dụng model trên cloud càng nhiều càng tốt và cũng muốn thử xem model local đã tốt hơn xưa chưa. Sau cùng mình nhận ra là không phải cứ nhét model lớn là nó sẽ ngon, nó chỉ ngon khi anh em dựng bộ khung cho nó tốt, thì dù thả mô hình nhỏ vào nó cũng có thể làm được việc mà anh em không ngờ đến.
Nguồn thông tin: Tổng hợp và biên tập độc quyền từ chuyên trang công nghệ Sharevina.com.