
GitHub, số commit tăng 110 lần trong 2 năm và nút thắt nằm ở hạ tầng và việc kiểm định chất lượng
Tháng 4/2026, GitHub nhận 1,4 tỉ commit mỗi tháng rồi đến tháng 8 con số này tăng gấp đôi lên 2,9 tỉ, để rồi tại hội nghị GitHub Universe, GitHub công bố con số 7,4 tỉ. Trước đó vào năm 2024, số lượng commit mỗi tháng chỉ vào khoảng 65 triệu. Như vậy chỉ sau hai năm, số lượng commit đã tăng hơn 110 lần. GitHub gọi động lực chính của sự tăng trưởng là “agentic demand”, tức nhu cầu từ các agent AI tự viết và đẩy code lên nên tảng này.
Khi agent đẩy code nhanh hơn người, hạ tầng phải được dựng lại chứ không chỉ mở rộng thêm
Với GitHub, 7,4 tỉ commit mỗi tháng trước hết là một vấn đề sức chịu tải: hệ thống phải nhận, lưu và xử lý khối lượng ghi dữ liệu lớn gấp nhiều lần so với trước đây. Hồi tháng 8, CTO Vlad Fedorov cho biết GitHub đã phải thêm 3 triệu nhân CPU, chủ yếu trên Azure. Giờ đây họ dự kiến thêm 4 triệu nhân nữa, kèm theo 160 petabyte lưu trữ tốc độ cao và 50 Tb/s băng thông mạng. GitHub cũng bổ sung tài nguyên cho GitHub Actions, hệ thống tự chạy build và kiểm thử mỗi khi có code mới. Bên cạnh đó, GitHub đang tách phần tính toán khỏi phần lưu trữ, tức hai phần này được mở rộng độc lập với nhau và benchmark nội bộ cho thấy thông lượng ghi có thể tăng tới 35 lần. Jay Parikh, phó chủ tịch điều hành mảng Core AI của Microsoft, cho biết agent không chỉ làm lượng code tăng lên mà còn thay đổi cách phát triển phần mềm diễn ra. Thêm máy chủ một mình không giải quyết được điều đó, nên kiến trúc cũng phải đổi theo. Tuy vậy, tách tính toán khỏi lưu trữ không phải kỹ thuật mới, nên có lẽ GitHub đã chạy trên kiến trúc cũ quá lâu trước khi thay đổi. Ngoài ra, việc chuyển sang Azure gần như là lựa chọn duy nhất, vì trung tâm dữ liệu riêng của họ đã hết chỗ.
Số commit đo lượng code được đẩy lên, còn khâu duyệt và chất lượng mới là phần chưa ai đo
Điểm khiến mình để ý là mình chưa thấy con số nào về pull request, tức yêu cầu gộp code, nơi con người thường đọc và duyệt. Commit chỉ là thước đo đầu vào: nó cho biết agent làm việc nhiều, không cho biết phần mềm có tốt hơn không. Dĩ nhiên, đây là suy luận của mình chứ chưa phải dữ liệu, nhưng nếu lượng code tăng hơn một trăm lần mà số người đọc không tăng theo, khâu duyệt code có nhiều khả năng sẽ là chỗ nghẽn tiếp theo.
Hình ảnh minh họa cho GitHub, số commit tăng 110 lần trong 2 năm và nút thắt nằm ở hạ tầng và việc kiểm định chất lượng. Ảnh: Tư liệu
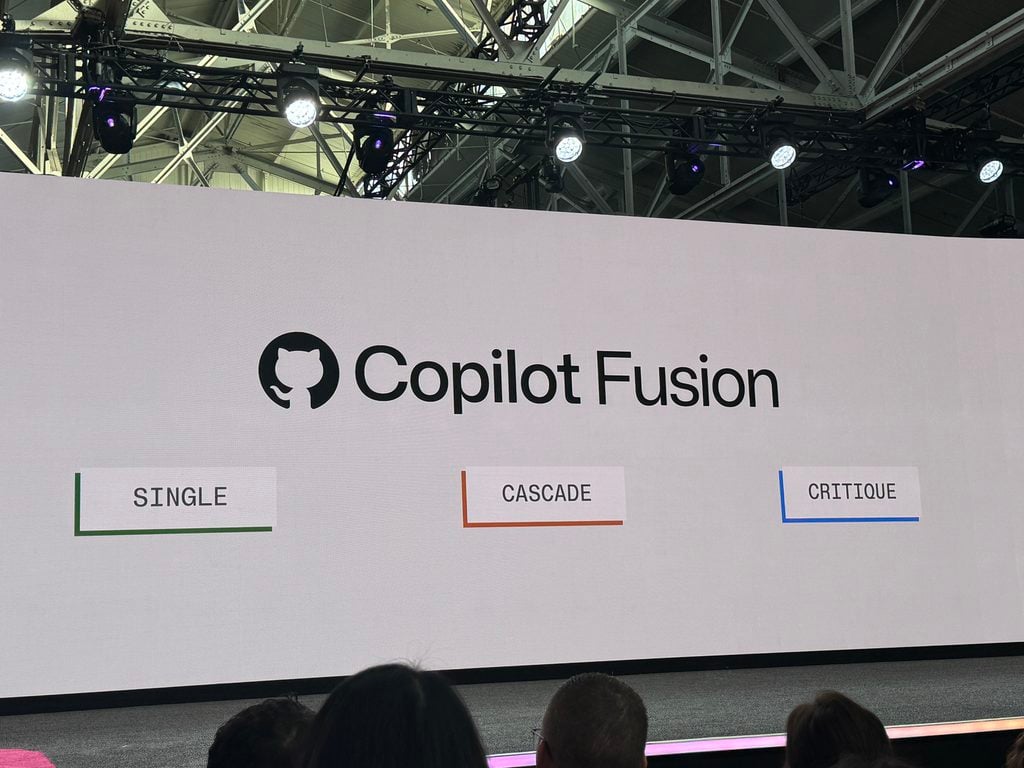
Copilot Fusion, công cụ GitHub vừa ra mắt rộng rãi tại cùng hội nghị, có một điểm liên quan đến khâu duyệt code. Fusion tự chọn mô hình AI phù hợp cho từng bước của một tác vụ code, thay vì để lập trình viên tự chọn. Nó có ba cách phối hợp: một mô hình làm từ đầu đến cuối; một mô hình làm trước rồi một bước kiểm tra chất lượng quyết định nhận kết quả hay chuyển lên bước xử lý kỹ hơn; hoặc một mô hình viết và một mô hình khác soi lại bài đó. Lập trình viên chọn mức nỗ lực: Standard cho việc hằng ngày, High cho việc khó hơn, Max cho việc đòi hỏi cao nhất. Cách thứ ba là cách để máy gánh một phần việc duyệt. Nhưng mình chưa thấy GitHub nói nó thay được người duyệt đến đâu và theo mình con người vẫn cần nằm ở cuối chuỗi để đảm bảo chất lượng đầu ra. GitHub cho biết Fusion Max đạt 60 điểm trên Artificial Analysis Coding Agent Index, cao hơn 2 điểm so với Claude Code chạy Opus 5.5 Max, dùng khoảng một nửa số token, nhanh hơn khoảng 40% mỗi tác vụ và tốn khoảng một nửa chi phí API trung bình. Đây là số liệu do GitHub tự công bố. Cả bốn thước đo đó, gồm điểm số, lượng token, thời gian và chi phí, đều đo phía người viết code. Chưa có thước đo nào cho phía người đọc. Mình đọc con số 7,4 tỉ như một chỉ số của tải hạ tầng, chưa phải của năng suất.
Nguồn thông tin: Tổng hợp và biên tập từ chuyên trang công nghệ.