
Nvidia giải thích vì sao DLSS 4 đạt được hiệu quả cao hơn so với trước đây, tất cả nhờ Transformer
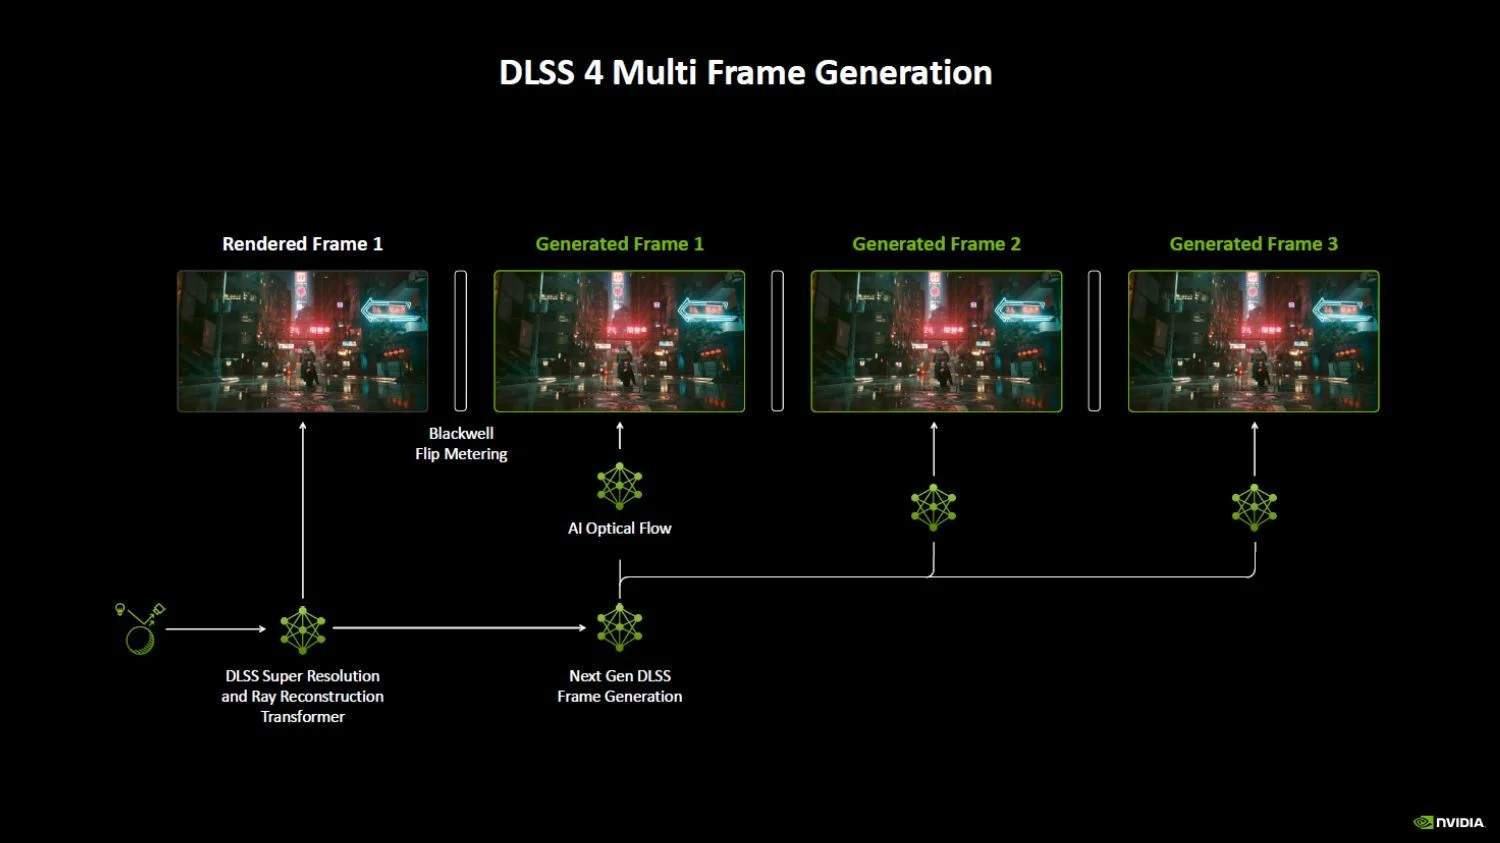
Trong khuôn khổ CES2025, Nvidia đã tổ chức một buổi Editor Day, trong đó kỹ sư của công ty đã giải thích cách hoạt động của công nghệ upscale AI DLSS 4. Nvidia cho biết công ty đã dành ra 6 năm để liên tục cải tiến công nghệ DLSS bằng hàng ngàn chiếc GPU để huấn luyện mô hình. Đặc biệt hơn, trên DLSS4, Nvidia đã chuyển sang dùng model AI phát triển dựa trên kiến trúc mạng nơ ron Transformer thay vì CNN (Convolutional Neural Networks) trước đây. Model AI mới có lượng tham số nhiều hơn gấp đôi với với model DLSS trước đây, từ đó cải thiện độ ổn định của hình ảnh do AI gen ra, giảm ghosting, viền của vật thể mượt hơn và độ chi tiết khi di chuyển cũng được cải thiện hơn. Sơ một chút cho bạn nào quan tâm, CNN trước giờ được đánh giá là rất mạnh trong việc xử lý dữ liệu hình ảnh. CNN dùng các phép toán tích chập nên không cần nhiều tham số so với các mạng nơ ron truyền thống, giúp nó hiệu quả hơn về mặt tính toán và dễ huấn luyện dựa trên các tập dữ liệu lớn. Các filter tích chập trong CNN sẽ “học” được các đặc trưng cục bộ trong hình ảnh, thí dụ như các góc, kết cấu,… Cho phép nó nhận diện các đối tượng trong hình hình. Và đây chính là bản chất của DLSS xưa giờ. Dù vậy, CNN có nhược điểm là khó nắm bắt được các thông tin mang tính toàn cục, nôm na là sự liên quan phụ thuộc giữa các phần tử trong một bức ảnh. Một nhược điểm khác là CNN đòi hỏi lượng rất lớn dữ liệu để huấn luyện mới đạt được hiệu suất cao. Trong khi đó Transformer xưa giờ mạnh hơn về khả năng xử lý ngôn ngữ tự nhiên. Rất nhiều dịch vụ chatbot phổ biến mà các bạn đang dùng hiện tại, bao gồm cả ChatGPT, Copilot, Gemini,… đều là dựa trên model Transformer. Không chỉ ứng dụng trong chatbot hjay xử lý ngôn ngữ tự nhiên, Transformer cũng được mở rộng sang mảng thị giác máy tính với model Vision Transformer (ViT). Hình ảnh sẽ được xử lý bằng cách chia nhỏ chúng thành các “miếng” và coi mỗi miếng này như một token để tính toán.
Hình ảnh minh họa cho Nvidia giải thích vì sao DLSS 4 đạt được hiệu quả cao hơn so với trước đây, tất cả nhờ Transformer. Ảnh: Tư liệu
Và đó chính là bản chất quyết định của Nvidia khi chuyển từ CNN sang ViT để vận hành DLSS 4. Bởi thế không khó hiểu khi Nvidia nói rằng họ đã dùng một lượng cực kỳ lớn GPU để tham gia vào quá trình huấn luyện model chạy DLSS 4. Nvidia chia sẻ thêm rằng trong quá trình phát triển và vận hành DLSS 4, họ đã chủ động hình thành được một tập dữ liệu đủ lớn, giúp model hiểu được thế nào là đồ họa đẹp và thế nào là DLSS upscale có vấn đề. Tập data này sẽ liên tục được cập nhật trong quá trình chạy DLSS 4, sau đó lại được dùng để tái huấn luyện model, rồi lại tiếp tục test với hàng trăm game để hoàn thiện tập data. Kết quả là DLSS 4 sẽ ngày càng tốt lên trong tương lai gần.
Nguồn thông tin: Tổng hợp và biên tập từ chuyên trang công nghệ.