
Robots.txt 32 tuổi, từ tấm biển chặn bot năm 1994 đến tín hiệu chung từ chối cho AI học
Ngày 30/10/2026, OpenAI, Google, Microsoft và Anthropic cùng cho biết sẽ tôn trọng một tín hiệu chung trong file robots.txt, để chủ website nói một lần “đừng lấy nội dung của tôi huấn luyện AI” thay vì phải liệt kê từng con bot của từng hãng. Nghe như một thay đổi kỹ thuật nhỏ, nhưng nó chạm vào một file văn bản vài dòng đã điều phối quan hệ giữa website và máy tìm kiếm suốt 32 năm, và chưa bao giờ có sức ép lớn như trong thời AI. Để hiểu vì sao một dòng chữ trong robots.txt lại quan trọng, phải quay về thời web còn nhỏ đến mức người ta có thể kể tên hết mọi con bot.
Hình ảnh minh họa cho Robots.txt 32 tuổi, từ tấm biển chặn bot năm 1994 đến tín hiệu chung từ chối cho AI học. Ảnh: Tư liệu
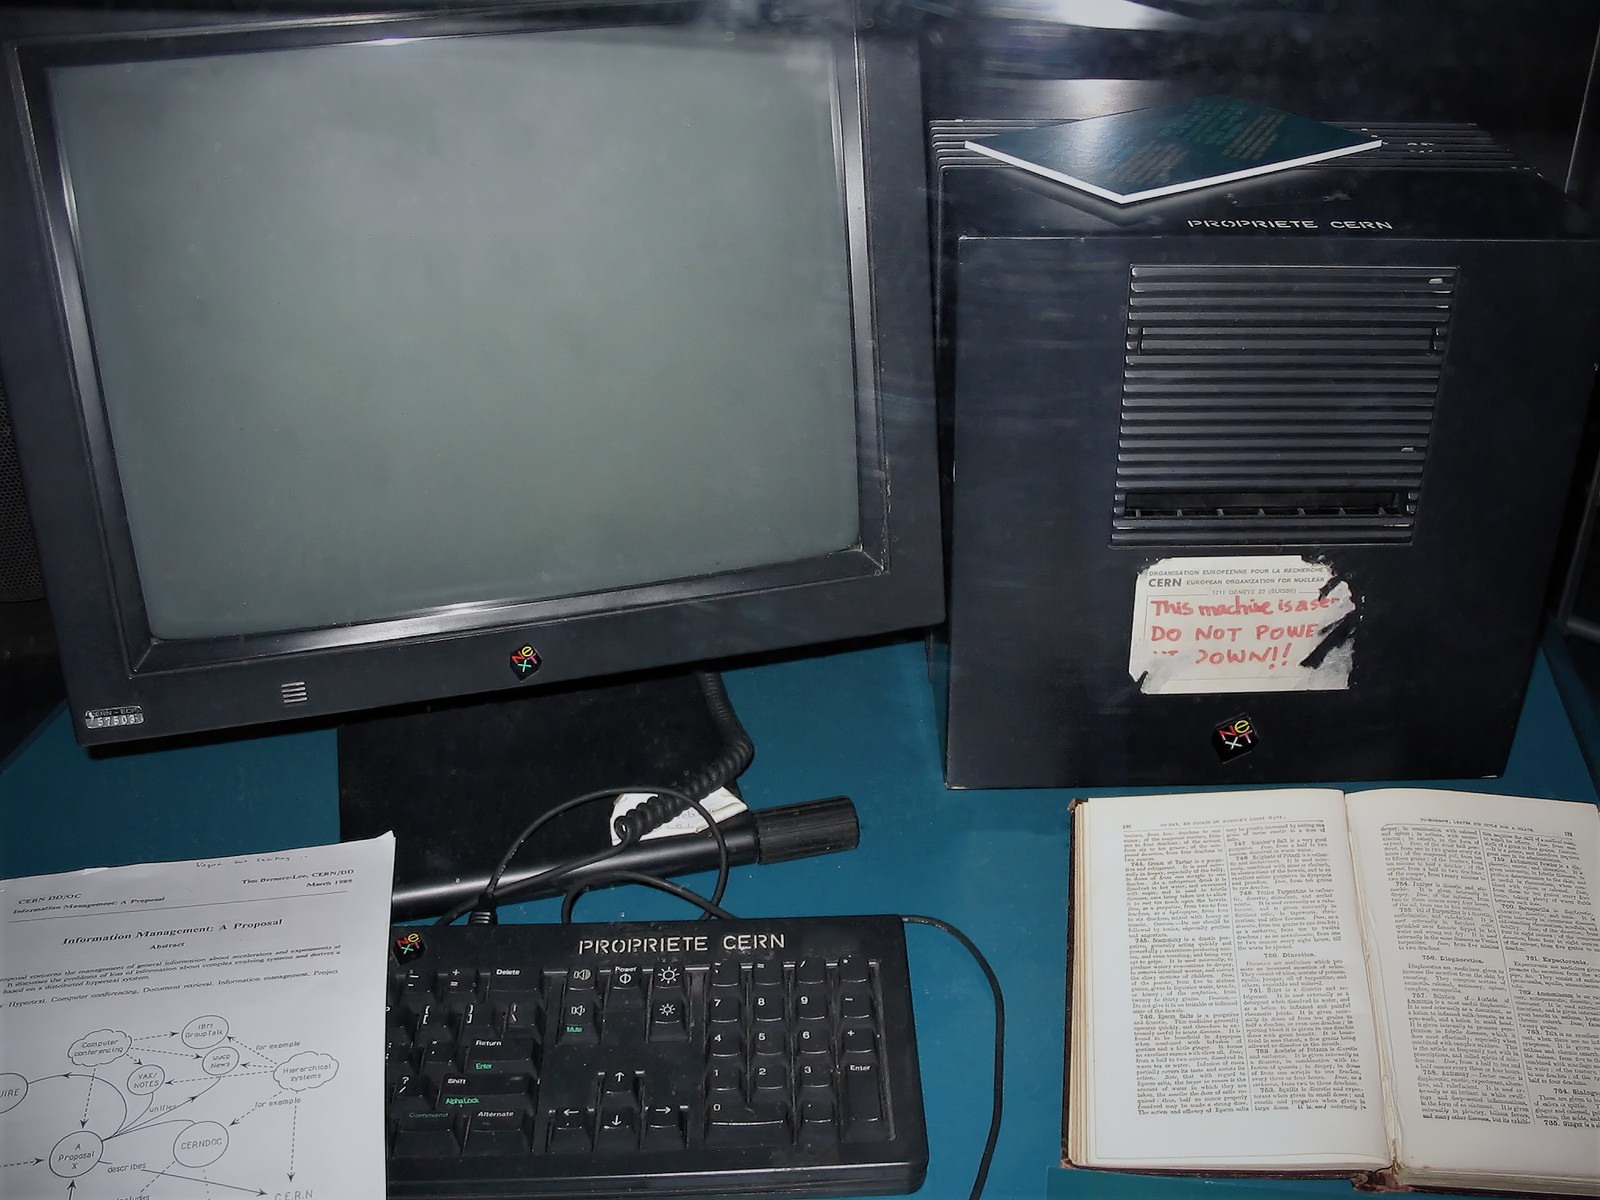
Chiếc máy NeXTcube mà Tim Berners-Lee dùng làm máy chủ web đầu tiên tại CERN. Đầu thập niên 1990, web còn đủ nhỏ để một con bot viết vội có thể làm nghẽn cả một máy chủ
Một con bot “cư xử tệ” và lời đề nghị năm 1994
Đầu những năm 1990, các chương trình tự động lần theo đường link để thu thập trang web, gọi là web crawler hay spider, bắt đầu xuất hiện. Máy chủ thời đó yếu, đường truyền chậm, nên một con bot tải trang liên tục có thể làm máy chủ quá tải không khác gì bị tấn công từ chối dịch vụ.
Hình ảnh minh họa cho Robots.txt 32 tuổi, từ tấm biển chặn bot năm 1994 đến tín hiệu chung từ chối cho AI học. Ảnh: Tư liệu
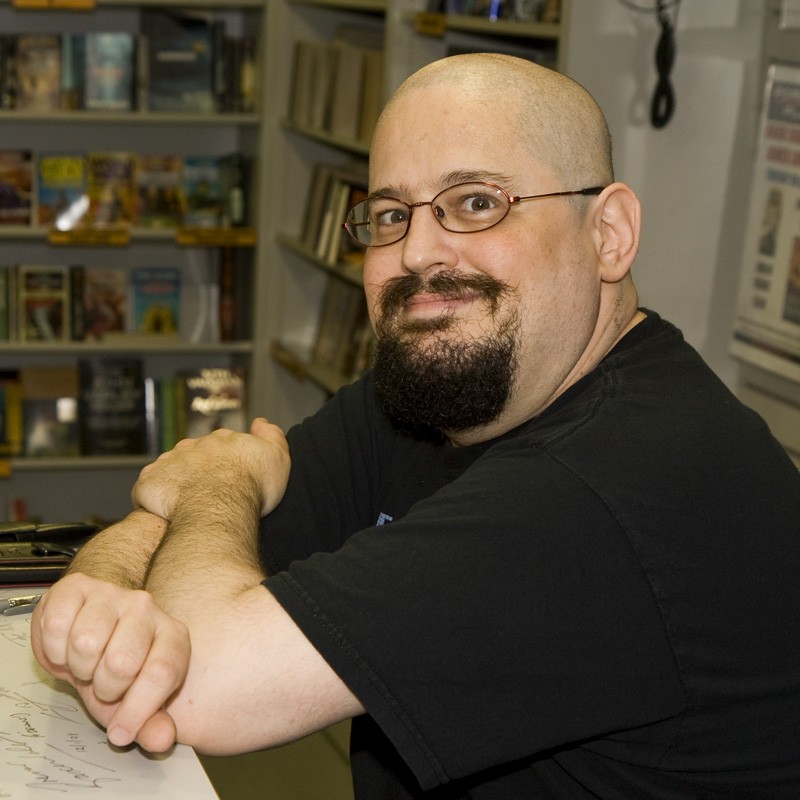
Nhà văn khoa học viễn tưởng Charles Stross năm 2009. Ông kể rằng con crawler viết lỗi của mình từng vô tình làm nghẽn máy chủ của Koster, góp phần dẫn đến robots.txt Câu chuyện phía sau có một nhân vật bất ngờ: Charles Stross, người sau này thành nhà văn khoa học viễn tưởng nổi tiếng. Trên blog cá nhân, Stross kể rằng ông đã viết một con crawler “cư xử tệ”, vô tình gây ra một vụ từ chối dịch vụ trên máy chủ của Koster, và chính chuyện đó đã thúc Koster đưa ra đề xuất. Điều đáng chú ý là robots.txt chưa bao giờ là một hàng rào. Nó chỉ là một lời đề nghị, bot tuân thủ hay không là do người viết bot. Vậy mà nó vẫn chạy: đến tháng 6/1994, robots.txt đã thành chuẩn trên thực tế, và các máy tìm kiếm lớn thời đó như WebCrawler, Lycos, AltaVista đều làm theo. Lý do là hai bên cùng có lợi: website tránh bị quá tải, máy tìm kiếm tránh bị chặn hẳn và vẫn đưa trang vào kết quả để kéo người đọc về.
Thỏa thuận ngầm “cho đọc, đổi lại người xem”
Trong gần 30 năm, robots.txt tồn tại như một quy ước không có giấy tờ chính thức. Phải đến ngày 1/7/2019, Google mới đề nghị đưa nó thành tiêu chuẩn của IETF (Lực lượng Đặc nhiệm Kỹ thuật Internet, tổ chức soạn các chuẩn như HTTP), và tháng 9/2022 nó được công bố thành RFC 9309, với tên Martijn Koster đứng đầu danh sách tác giả. [IMG3
Hình ảnh minh họa cho Robots.txt 32 tuổi, từ tấm biển chặn bot năm 1994 đến tín hiệu chung từ chối cho AI học. Ảnh: Tư liệu
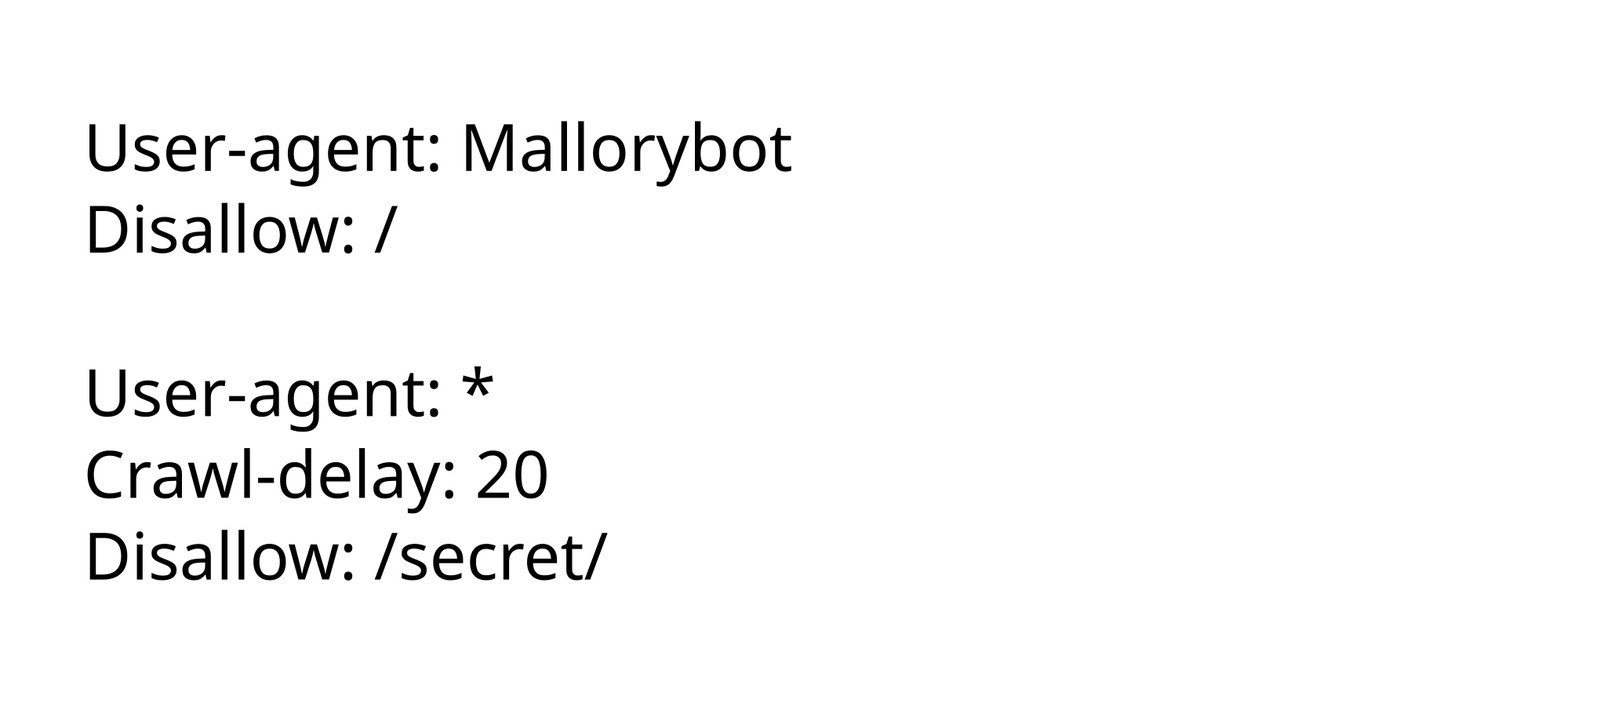
Một file robots.txt cơ bản: con bot tên “Mallorybot” bị cấm vào toàn bộ website, các bot khác chỉ được tải 1 trang mỗi 20 giây và không được vào thư mục “secret”
Trò chơi đuổi bắt với hàng chục con bot
Vấn đề là cách làm này buộc chủ website chơi trò đuổi bắt. Mỗi hãng AI một con bot, mỗi con bot một tên, và tên thì thay đổi. Năm 2024, 404 Media phản ánh các website đang chặn nhầm bot vì công ty AI liên tục tạo crawler mới thay cho những cái tên đã nằm trong danh sách chặn, trong đó có Anthropic và Perplexity. Có những con bot vừa phục vụ tìm kiếm vừa phục vụ AI, chặn thì mất cả hai.
Hình ảnh minh họa cho Robots.txt 32 tuổi, từ tấm biển chặn bot năm 1994 đến tín hiệu chung từ chối cho AI học. Ảnh: Tư liệu
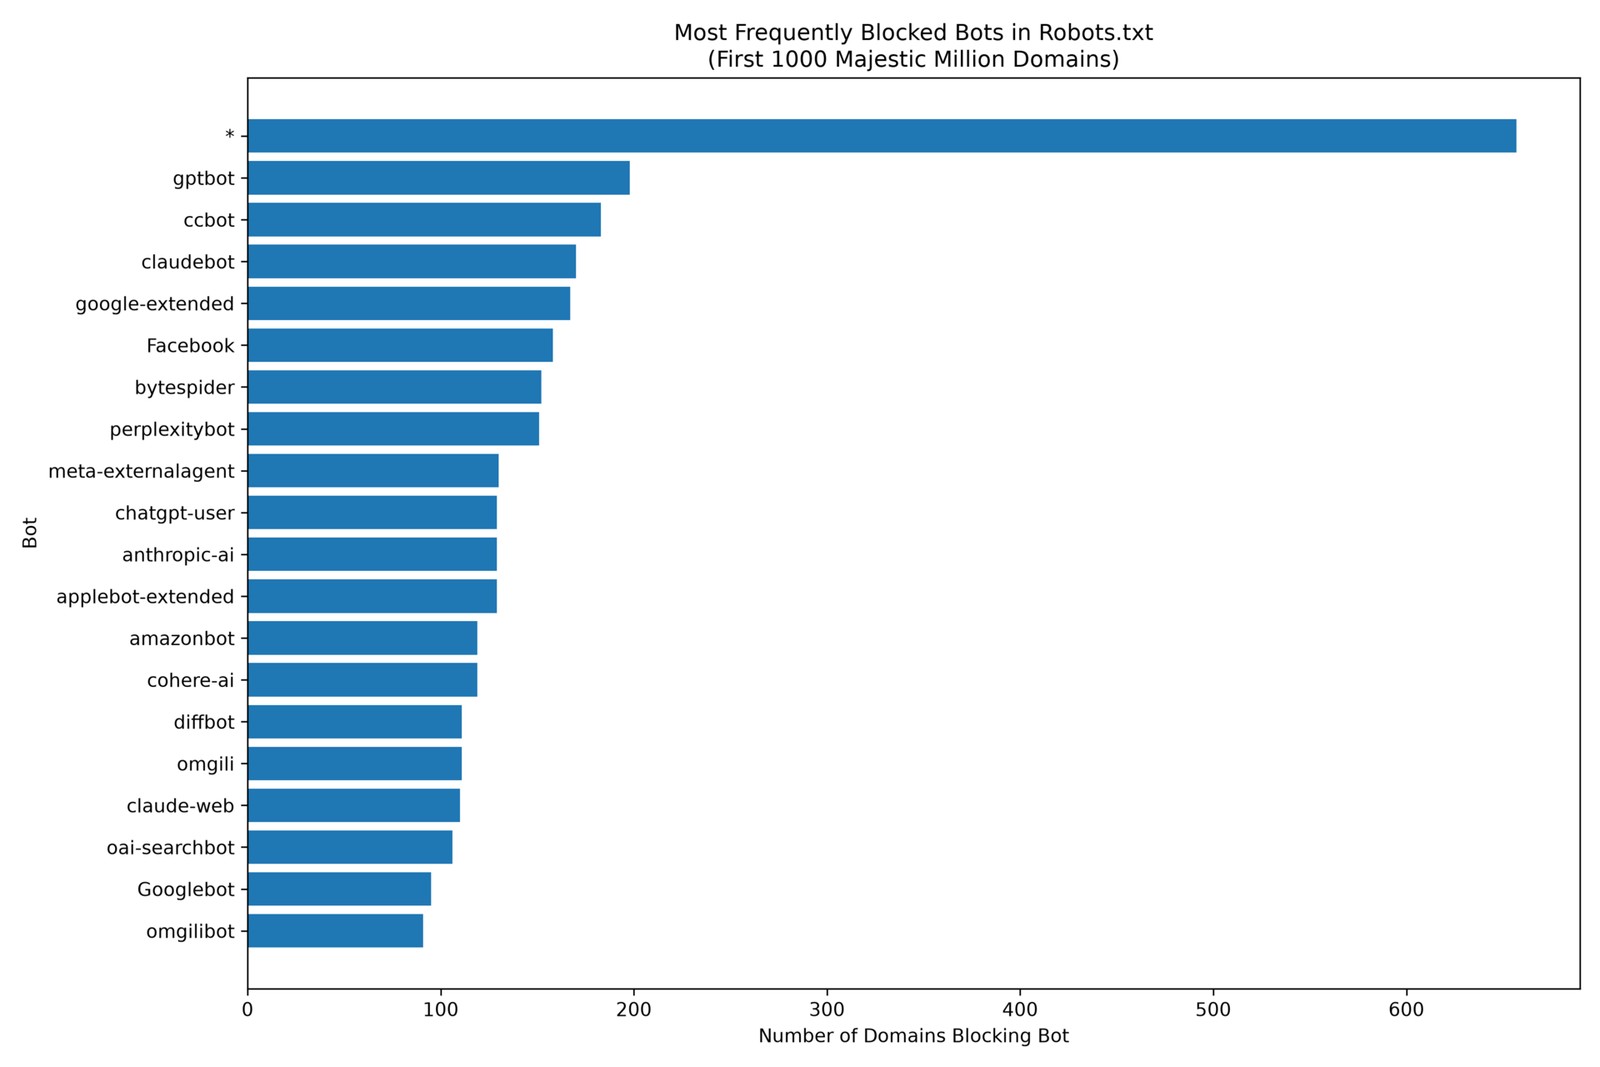
Những bot bị chặn nhiều nhất trong robots.txt của 1.000 tên miền hàng đầu theo danh sách Majestic Million, số liệu tháng 6/2026 do một thành viên Wikimedia Commons tự thu thập. Ngoài dấu * (mọi bot), GPTBot, CCBot, ClaudeBot và Google-Extended đứng đầu Biểu đồ trên cho thấy thực tế đó: trong 1.000 tên miền được khảo sát, gần 200 website chặn GPTBot, và phần lớn các tên trong danh sách là bot AI. Chính Googlebot, con bot tìm kiếm, lại bị chặn ít hơn tất cả.
Tín hiệu chung: một dòng cho mọi hãng
Đề xuất công bố ngày 30/10 đến từ Kevin Kelley, phụ trách tiêu chuẩn kỹ thuật tại Anthropic. Thay vì phát minh cú pháp mới, nó tận dụng chính cấu trúc cũ của robots.txt bằng một “policy token”, tức một cái tên đặt ở dòng User-agent nhưng không thuộc về con bot nào, mà đại diện cho một mục đích sử dụng: User-Agent: __usage_ai-training Disallow: / Allow: /press-kit/ Ví dụ trên nghĩa là website không muốn nội dung bị dùng để huấn luyện AI, trừ thư mục /press-kit/. Tiền tố hai dấu gạch dưới giúp không trùng với tên bot thật, và dòng User-agent: * không được tính là khớp với token này, nên một file chặn mọi bot sẵn có sẽ không vô tình bị hiểu thành lựa chọn về AI. Vì không thêm cú pháp nào mới, các trình đọc robots.txt cũ sẽ bỏ qua nhóm này như với một con bot lạ, không có gì bị phá vỡ. Định nghĩa “huấn luyện AI” được lấy từ nhóm AIPREF: dùng nội dung để thay đổi tham số đã học của một mô hình AI tạo sinh. Một điểm dễ hiểu lầm: token này không ra lệnh cho bot ngừng ghé website. Nó chỉ nói nội dung được dùng vào việc gì. Muốn hạn chế việc thu thập, chủ website vẫn phải viết luật riêng cho từng crawler như trước. Lộ trình của từng hãng khác nhau:
Vẫn là lời đề nghị, không phải hàng rào
Cần nói rõ, văn bản của Kelley hiện chỉ là một Internet-Draft cá nhân, chưa được IETF thông qua, và sẽ hết hạn vào ngày 3/5/2027 nếu không được cập nhật. Giống robots.txt năm 1994, nó vẫn là cơ chế tự nguyện: con bot nào không muốn tuân thủ thì file văn bản không thể ngăn được. Tín hiệu cũng chỉ có tác dụng từ lúc nó được ghi vào, không xóa được những gì đã nằm trong dữ liệu huấn luyện trước đó. Dù vậy, có hai lý do để coi đây là bước tiến. Thứ nhất, lần đầu tiên các hãng AI lớn nhất cùng đọc một tín hiệu, chủ website không phải đuổi theo danh sách tên bot dài thêm mỗi tháng. Thứ hai, áp lực pháp lý đang đến: Google nhấn mạnh đề xuất phù hợp với Bộ quy tắc thực hành dành cho nhà cung cấp mô hình AI đa dụng theo Đạo luật AI của EU, vốn coi robots.txt là cách chính để website bày tỏ lựa chọn mà máy đọc được. Ba mươi hai năm trước, robots.txt ra đời vì một con bot làm nghẽn máy chủ. Lần này, nó được mở rộng vì AI đọc nội dung mà không gửi lại người đọc. Cái giữ cho nó chạy vẫn như năm 1994: đủ nhiều bên lớn đồng ý làm theo. Nguồn: The Verge, OpenAI, Google Search Central, IETF Datatracker, Wikipedia
Nguồn thông tin: Tổng hợp và biên tập từ chuyên trang công nghệ.