
LongCat-2.5: Từ Lệnh Cấm Chip Đến Model 1.6 Nghìn Tỷ Tham Số Không Cần GPU Nvidia
Meituan, tập đoàn công nghệ và giao đồ ăn hàng đầu Trung Quốc, vừa chính thức công bố và mở toàn bộ trọng số mã nguồn mở của LongCat-2.5. Đây là mô hình trí tuệ nhân tạo (AI) quy mô khổng lồ với 1,6 nghìn tỷ tham số, chuyên đảm nhận các tác vụ tự động hóa nhiều bước (agentic workflows), đặc biệt là khả năng lập trình và viết code. Tuy nhiên, điểm gây chấn động giới công nghệ quốc tế không chỉ nằm ở quy mô 1,6 nghìn tỷ tham số, mà nằm ở việc mô hình này được huấn luyện hoàn toàn trên hạ tầng phần cứng nội địa Trung Quốc mà không cần đến sự hỗ trợ của GPU Nvidia.
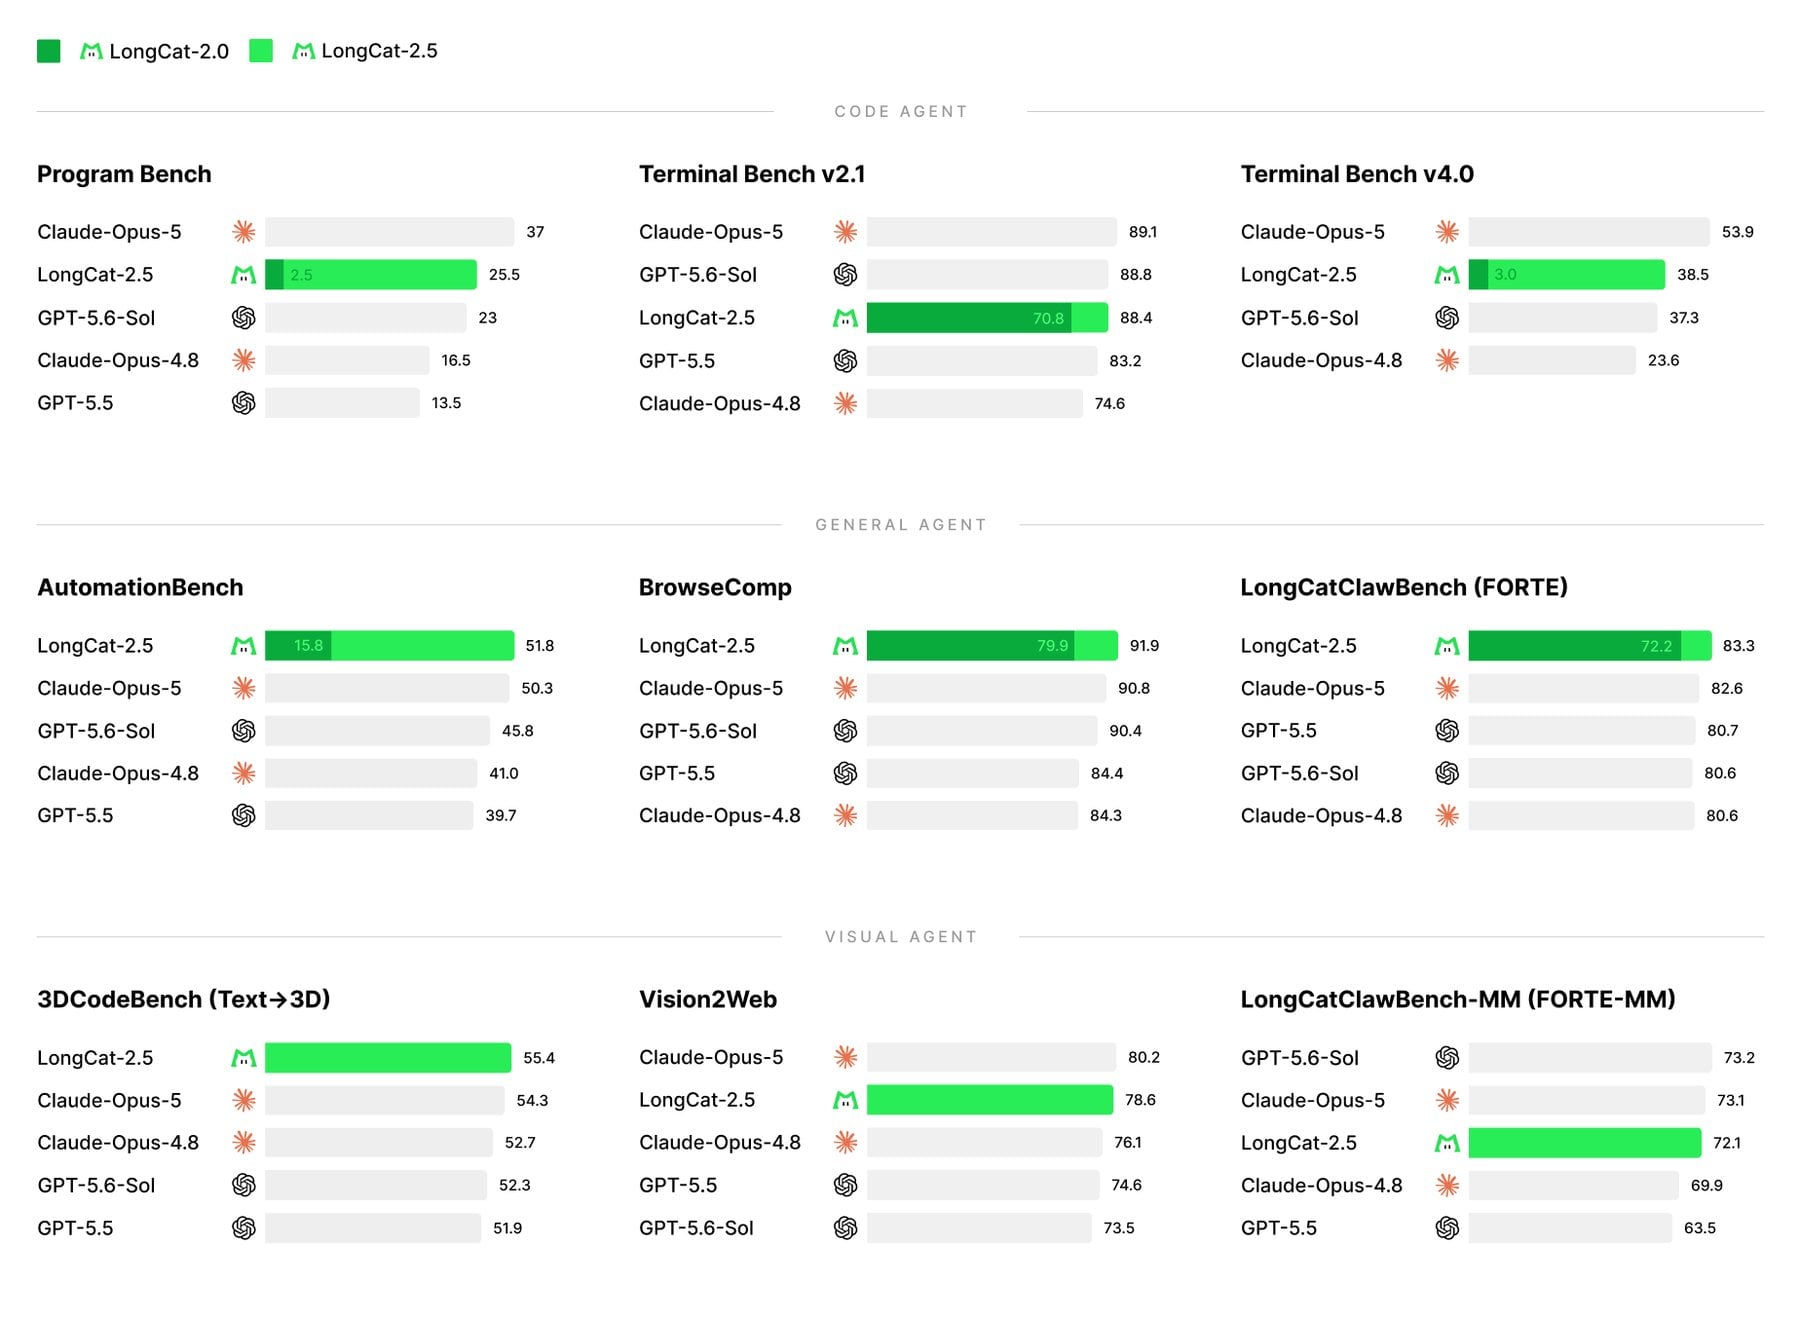
Bảng điểm do Meituan công bố: LongCat-2.5 (thanh xanh lá) so với Claude Opus 5, GPT-5.6 Sol và các model hàng đầu thế giới. Ảnh: Meituan
Từ lệnh cấm chip đến bước ngoặt “không cần Nvidia”
Câu chuyện phát triển của LongCat bắt đầu từ tháng 10/2022, thời điểm Mỹ siết chặt các quy định kiểm soát xuất khẩu chip AI tiên tiến sang thị trường Trung Quốc. Đứng trước rào cản này, các phòng nghiên cứu AI tại Trung Quốc buộc phải áp dụng chiến lược kép: vừa tiết kiệm tối đa từng cụm GPU Nvidia hiện có, vừa dồn lực nghiên cứu các giải pháp thay thế hoàn toàn dựa trên chip nội địa.
Phiên bản tiền nhiệm LongCat-2.0 từng được huấn luyện vào cuối tháng 6/2026 trên cụm tính toán gồm hơn 50.000 chip AI Trung Quốc và vận hành thử nghiệm ẩn danh trên hệ thống OpenRouter với định danh “Owl Alpha” trước khi chính thức trình làng. Tiếp nối nền tảng đó, LongCat-2.5 mang đến bước nhảy vọt mới với khả năng tiếp nhận thị giác (multimodal) và được phát hành toàn bộ trọng số theo giấy phép nguồn mở MIT, cho phép cộng đồng tự do nghiên cứu, chỉnh sửa và ứng dụng thương mại.
Kiến trúc 1,6 nghìn tỷ tham số, nhưng chỉ kích hoạt 48 tỷ tham số
LongCat-2.5 được xây dựng dựa trên kiến trúc chuyên gia hỗn hợp (Mixture of Experts – MoE). Bên trong mô hình chứa nhiều mạng chuyên biệt nhỏ đảm nhận các tác vụ khác nhau, và mỗi token dữ liệu khi xử lý chỉ kích hoạt một nhóm chuyên gia nhất định. Nhờ đó, dù sở hữu tổng quy mô lên đến 1,6 nghìn tỷ tham số, mô hình chỉ sử dụng khoảng 48 tỷ tham số kích hoạt cho mỗi lượt tính toán. Con số 48 tỷ tham số này giúp tối ưu hóa chi phí vận hành và tốc độ phản hồi cực nhanh, trong khi vẫn duy trì kho tri thức khổng lồ của 1,6 nghìn tỷ tham số.
Hệ thống giao diện lập trình ứng dụng (API) của LongCat-2.5 hỗ trợ cửa sổ ngữ cảnh đầu vào lên tới 1 triệu token và khả năng phản hồi tối đa 128.000 token trong một lượt trả lời. Độ dài ngữ cảnh ấn tượng này cho phép mô hình nuốt trọn toàn bộ kho mã nguồn của một dự án lớn, phân tích cấu trúc phức tạp và trực tiếp triển khai các đoạn mã tiếp theo một cách chuẩn xác. Ngoài ra, người dùng có thể linh hoạt chuyển đổi giữa chế độ suy luận nhanh hoặc suy luận chuyên sâu tùy theo độ phức tạp của bài toán.
Khả năng đa phương thức: Nhận diện hình ảnh và đọc hiểu video
Khác với thế hệ 2.0 vốn chỉ giới hạn ở việc xử lý văn bản thuần túy, LongCat-2.5 là một mô hình đa phương thức toàn diện với khả năng đọc hiểu song song cả văn bản, hình ảnh lẫn video. Điểm độc đáo trong cách tiếp cận của Meituan là không sử dụng bộ mã hóa hình ảnh riêng biệt (như Vision Encoder truyền thống), mà chia nhỏ ảnh ở độ phân giải gốc thành các token rời rạc rồi đưa trực tiếp vào mạng xử lý chung với token văn bản. Giải pháp này giúp tối ưu vượt trội các tác vụ lập trình giao diện từ ảnh chụp thiết kế (UI-to-Code), đồ họa kỹ thuật số và dựng hình không gian 3D.
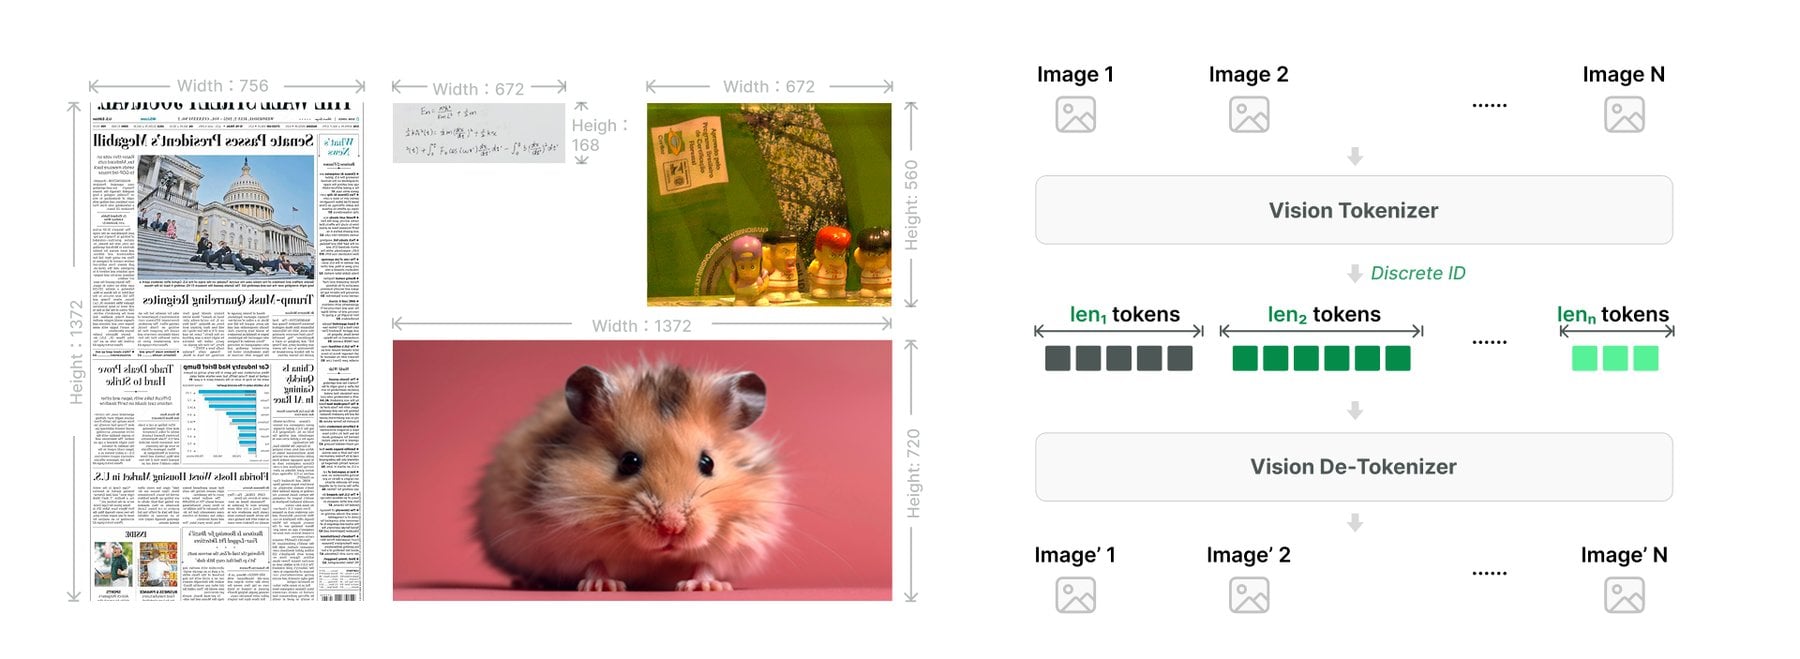
LongCat-2.5 cắt ảnh ở độ phân giải gốc thành các token rời rạc rồi xử lý đồng nhất cùng với văn bản. Ảnh: Meituan
Quy trình huấn luyện tăng cường từ tác vụ thực tế trên GitHub
Để đào tạo kỹ năng giải quyết công việc tự động độc lập cho mô hình, đội ngũ kỹ sư LongCat đã thu thập hàng loạt tác vụ lập trình thực tế từ các yêu cầu kéo mã (pull requests) trên GitHub, kết hợp với bộ dữ liệu mô phỏng lại các sai sót mà các AI Agent từng gặp phải trong thực tế. Môi trường huấn luyện được cô lập hoàn toàn khỏi mạng internet, xóa toàn bộ lịch sử Git và bộ nhớ cache để ngăn mô hình “học vẹt” hoặc tra cứu giải pháp có sẵn. Một mô hình ngôn ngữ độc lập thứ hai được sử dụng để thẩm định lời giải, loại bỏ các thủ thuật lách luật gian lận.
Bên cạnh đó, Meituan còn ứng dụng phương pháp chưng cất tri thức (Knowledge Distillation) từ nhiều mô hình chuyên gia hàng đầu về tác vụ agent, năng lực suy luận toán học và kỹ năng đối thoại logic để hội tụ vào thể thống nhất trong LongCat-2.5.
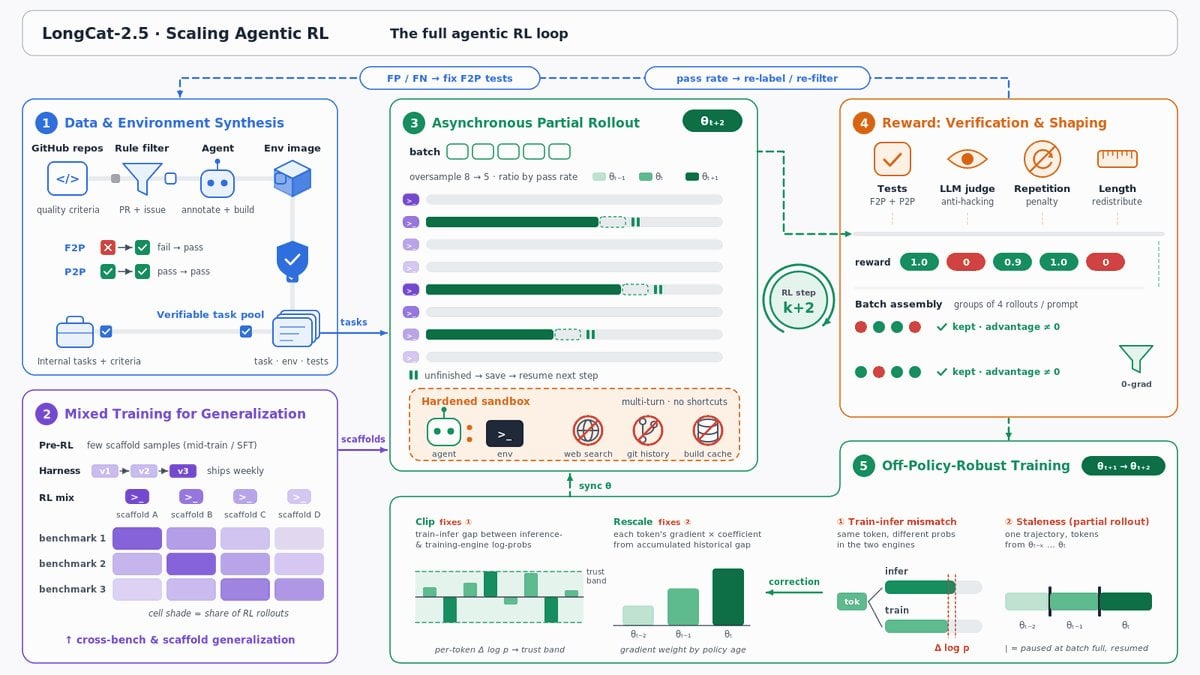
Vòng lặp huấn luyện tăng cường của LongCat-2.5: từ sinh tác vụ từ kho mã GitHub đến chấm điểm và tinh lọc kết quả. Ảnh: Meituan
Kết quả Benchmark: Bám sát các tên tuổi hàng đầu thế giới
Dữ liệu hiệu năng do Meituan công bố cho thấy LongCat-2.5 đạt kết quả rất ấn tượng. Trong bài kiểm tra dòng lệnh Terminal-Bench v2.1 (đánh giá năng lực thao tác terminal tự động), mô hình đạt 88,4 điểm, bám sát các đỉnh cao như Claude Opus 5 (89,1 điểm) và GPT-5.6 Sol (88,8 điểm), dù vẫn xếp sau DeepSeek-V4.1-Flash (90,6 điểm). Ở bài kiểm tra nâng cao Terminal-Bench v4.0, LongCat-2.5 ghi được 38,5 điểm, nhỉnh hơn GPT-5.6 Sol (37,3 điểm) dù còn khoảng cách với Opus 5 (53,9 điểm).
Tại bài đo DeepSWE (đánh giá khả năng sửa lỗi trực tiếp trên các kho mã nguồn thực tế), LongCat-2.5 đã ghi nhận bước nhảy vọt phi thường khi tăng từ 9,7 điểm ở phiên bản 2.0 lên 64,6 điểm ở phiên bản 2.5. Đặc biệt, trong bài kiểm tra tìm kiếm và tổng hợp thông tin BrowseComp, mô hình dẫn đầu bảng xếp hạng với 91,9 điểm.
Cần lưu ý rằng các điểm số trên đều do phòng thí nghiệm của Meituan tự đo lường nội bộ và chưa qua kiểm định độc lập từ bên thứ ba. Tuy nhiên, việc phát hành mã nguồn mở toàn diện cùng bộ trọng số đầy đủ cho phép bất kỳ tổ chức hay nhà nghiên cứu nào có đủ hạ tầng đều có thể tự kiểm chứng và đối chiếu hiệu năng thực tế.
Tối ưu nén lượng tử hóa 4-bit và chi phí vận hành API siêu rẻ
Nhằm giải quyết triệt để bài toán hiệu năng trên phần cứng nội địa, Meituan đã ứng dụng công nghệ nén lượng tử hóa trọng số và kích hoạt của các khối chuyên gia xuống định dạng 4-bit chuyên dụng cho chip xử lý AI Trung Quốc. Kết quả kiểm thử thực nghiệm cho thấy tốc độ xử lý câu lệnh (prompt) tăng 43,3% và tốc độ sinh phản hồi tăng 42,77% so với phiên bản 8-bit, trong khi độ chuẩn xác vẫn tương đương nguyên bản.
Tài liệu hướng dẫn tự vận hành (self-host) do Meituan phát hành mô tả một cụm hạ tầng gồm 194 vi xử lý Huawei Ascend Atlas A2: bao gồm 2 chip phân tích xử lý thị giác, 64 chip xử lý dữ liệu prompt đầu vào và 128 chip chuyên trách sinh nội dung phản hồi. Đáng chú ý, toàn bộ kiến trúc vận hành không chứa bất kỳ thành phần nào của GPU Nvidia.
Về mặt chi phí thương mại, gói API khởi điểm được áp dụng mức giá cực kỳ cạnh tranh, chỉ khoảng 0,27 euro cho mỗi triệu token đầu vào và 1,07 euro cho mỗi triệu token đầu ra. Giao diện API được chuẩn hóa hoàn toàn tương thích với chuẩn OpenAI và Anthropic, giúp các lập trình viên dễ dàng tích hợp ngay vào các công cụ phát triển phổ biến như Claude Code, Cursor hay Hermes.
Nhận định: Cột mốc mới cho làn sóng AI tự chủ
Dù chưa phải là mô hình giữ ngôi vương tuyệt đối trên mọi bảng xếp hạng, LongCat-2.5 đã khẳng định một cột mốc quan trọng: một mô hình AI mã nguồn mở quy mô 1,6 nghìn tỷ tham số hoàn toàn có thể được huấn luyện và vận hành hiệu quả từ đầu đến cuối trên nền tảng vi xử lý nội địa Trung Quốc mà vẫn đủ sức cạnh tranh sòng phẳng với các tên tuổi hàng đầu phương Tây. Xu hướng tối ưu trực tiếp cho phần cứng nội địa ngay từ khâu thiết kế không chỉ giải tỏa áp lực cấm vận công nghệ, mà còn mở ra hướng đi bền vững cho các giải pháp AI tự chủ trong tương lai.
Nguồn thông tin: Tổng hợp từ tài liệu kỹ thuật của Meituan, báo cáo phân tích The Decoder và cộng đồng nghiên cứu AI Hugging Face.